Как RAG меняет процесс поиска знаний #
Агенты ИИ должны не только находить корпоративные знания, но и надежно преобразовывать их в решения и действия. Для этого редко бывает достаточно просто оцифровать страницы вики и отправить наиболее похожие фрагменты текста в модель LLM. Продуктивная система RAG, помимо семантического поиска, нуждается в базе данных, в которой сущности, связи, состояния и правила доступа сохраняются и остаются распознаваемыми для ИИ.
Основные факты: #
-
Ограничения неструктурированных данных: почему векторные базы данных и текстовые инструменты, такие как Notion, Obsidian или Confluence, могут приводить к потере контекста при работе со сложными ИИ-агентами.
-
Структура как фактор качества: как с помощью структурированных баз данных no-code, выступающих в качестве единого источника достоверной информации, обеспечить точность запросов и в значительной степени воспроизводимые ответы ИИ.
-
Архитектура будущего: Какую роль в системе управления знаниями на основе ИИ вашей компании играют технологии «Retrieval-Augmented Generation», агенты ИИ и серверы MCP (Model Context Protocol).
-
Контроль затрат и данных: как с помощью фильтрации метаданных, целевого поиска и повышения эффективности токенов улучшить управление и контроль затрат.
Что означает аббревиатура RAG? #
Аббревиатура RAG означает Retrieval-Augmented Generation и обозначает специфическую схему, позволяющую связывать языковые модели с внешними источниками знаний, такими как корпоративные базы данных. Вместо того чтобы опираться исключительно на знания, полученные в ходе обучения, система RAG сначала ищет релевантную информацию и передаёт её в качестве контекста используемой модели ИИ. Этот принцип сделал технологию RAG AI одним из ключевых компонентов современных корпоративных помощников, специализированных для конкретных областей. Векторный поиск позволяет находить в больших базах данных семантически схожий контент и значительно сократить объём фактически обрабатываемого контекста.
Для компаний это означает, что им не придётся заново обучать свои языковые модели после каждого изменения внутренних документов. Вместо этого современная система управления знаниями на базе RAG-ИИ извлекает актуальные источники и динамически предоставляет предметные знания. Таким образом, из пассивной документации потенциально формируются так называемые «Actionable Data», на основе которых агенты RAG-ИИ запускают дополнительные инструменты или инициируют процессы.
Слабое место классических систем #
Однако качество системы RAG в значительной степени зависит от того, какие данные вообще индексируются, и как функционируют разбиение на фрагменты и индексирование. Зачастую системы одинаково обрабатывают практически все сохраненные знания: контент извлекается, разбивается на чанки — то есть на более мелкие единицы, — векторизируется и сохраняется в базе данных RAG. Такой подход хорошо работает для узконаправленных запросов, в которых ищутся похожие формулировки или соответствующие фрагменты текста. Однако как только вы задаете более сложный вопрос, для ответа на который вашему ИИ-агенту необходимо использовать многоуровневые связи между данными, точные фильтры или агрегации, в такой конфигурации становится сложнее получить надёжные, детерминированные ответы ИИ.
Правда, в зависимости от поставщика вы можете выполнять ограниченную фильтрацию и агрегацию через API. Однако это лишь частично устраняет проблему отсутствия связей, и вы остаетесь зависимыми от качества фильтрации, предоставляемой API. Кроме того, использование API в некоторых случаях сопряжено с дополнительными затратами; причём эти затраты являются ненужными, поскольку те же самые запросы можно выполнять напрямую в реляционной базе знаний.
Векторные базы данных: Сильные в плане схожести, слабые в плане точности #
Векторные базы данных, такие как Pinecone и Chroma, хранят вложения (embeddings) и оптимизированы для быстрого обнаружения схожести между фрагментами (chunks). Однако это не означает, что они не имеют структуры. Помимо векторов они также могут управлять идентификаторами, текстами и метаданными. Однако недостатком типичных векторных баз данных является то, что они не моделируют референциальную целостность автоматически.
Возьмём в качестве примера типичную CRM-среду. Классическая система RAG на основе векторной базы данных может, например, ответить на вопрос: «Какие запросы в службу поддержки похожи на этот тикет?». Однако для ответа на другой вопрос необходимо объединить различную информацию в контексте, например: «Какие активные клиенты в стране X с годовым оборотом более Y подавали запрос в службу поддержки за последние 12 месяцев?», требует, напротив, точных связей и фильтров, для чего систему RAG необходимо объединить с базой знаний SQL.
Notion, Obsidian и Confluence: устраняют хаос в документах, но не предоставляют структурированных данных #
Даже системы на основе Markdown или блоков, такие как Obsidian, Notion или Confluence, не являются принципиально неструктурированными. Точнее будет говорить о полуструктурированных системах:
-
Базы данных Notion поддерживают типизированные свойства
-
Obsidian поддерживает свойства на основе YAML
-
Confluence может хранить свойства в формате JSON
В качестве основы для управления знаниями с помощью ИИ в вашей компании эти системы подходят лишь в ограниченной степени из-за своей структуры, основанной на страницах. Зачастую они по-прежнему используются просто как сборник страниц — в качестве корпоративной вики без метаданных, с разной логикой именования, несогласованными свойствами и дублирующимися записями. Если вы построите систему управления знаниями на базе ИИ на такой платформе, привычный «вики-хаос» никуда не исчезнет и не станет внезапно упорядоченным. Он просто станет доступным для семантического поиска.
Проблема потери контекста: почему модели большого языка (LLM) без чёткой структуры данных могут «галлюцинировать» #
Почему отсутствие контекста представляет собой проблему? При обработке документов или внутренних баз знаний структура может утрачиваться в нескольких местах. Основным фактором риска при работе с неструктурированными или полуструктурированными базами данных является так называемое преобразование с потерями: исходный документ или информация разбиваются на фрагменты, каждый фрагмент векторизуется отдельно и при последующих запросах используется в первую очередь на основе семантического сходства с поставленной задачей. Таблицы превращаются в текст, заголовки отделяются от соответствующих разделов, связи между взаимосвязанными утверждениями ослабляются, а связи между объектами сводятся к простым словам. Если впоследствии ваша система RAG обнаруживает лишь отдельные фрагменты, RAG может передавать в LLM, возможно, правильные утверждения. Однако контекст, ограничивающий их достоверность, при этом теряется.
Пример: у вас есть клиенты в разных регионах с различными условиями договоров. Без полного контекста агент может извлечь фактически верную информацию, которая, однако, не применима к данному региону или конкретному клиенту из-за особых факторов.
Потеря контекста может происходить на нескольких этапах:
-
Поступление данных: таблицы, свойства, ссылки или иерархии блоков сводятся к непрерывному тексту.
-
Разделение на фрагменты: связанная между собой информация попадает в разные фрагменты
-
Встраивание: отображается семантическое сходство, но не отображаются автоматически логические или причинно-следственные связи.
-
Поиск: чисто векторный поиск находит семантически схожие фрагменты, но не обязательно всю релевантную информацию.
-
Формирование запроса: метаданные и связи не передаются, либо релевантное содержание теряется в слишком длинном контексте.
Почему более крупные контекстные окна не предотвращают потерю контекста #
Чтобы предотвратить галлюцинации или ошибки извлечения, вы можете предоставить ИИ как можно больше контекста в запросе. Однако это не является надёжным решением. Дело в том, что с увеличением размера контекстных окон возрастает так называемый «риск Lost in the Middle». Исследования показывают, что в длинных контекстных окнах информация может использоваться с различной степенью надёжности в зависимости от её положения. Кроме того, регулярно наблюдалось снижение производительности исключительно из-за более длинных вводных данных.
Поэтому загрузка в промпт максимально большого объема информации или даже целых документов не только ухудшает эффективность использования токенов. Это также может создавать дополнительные помехи, если LLM приходится обрабатывать большой объем информации. При этом затраты обычно растут пропорционально количеству обрабатываемых токенов — не обязательно экспоненциально, — поскольку поставщики API рассчитывают стоимость входных и выходных токенов по объему. Оптимизация извлечения знаний (Knowledge Retrieval Optimization) подразумевает предоставление как можно меньшего, но полностью релевантного контекста.
Какие преимущества предлагают структурированные реляционные базы данных no-code для RAG? #
Структурированная реляционная база данных no-code может, например, хранить информацию о клиентах, продуктах, активах или контрактах в виде отдельных таблиц. Связи между таблицами отображают взаимоотношения, а однозначные типы данных и обязательные поля снижают неоднозначность. Таким образом, получаются структурированные, контекстуализированные данные, которые ваш ИИ-агент может фильтровать, сортировать, объединять и агрегировать, вместо того чтобы угадывать связи на основе фрагментов текста.
Именно такая архитектура данных делает возможными детерминированные, то есть воспроизводимые, ответы ИИ: при одинаковом наборе данных и одинаковых условиях ваш запрос к базе данных даст один и тот же результат. Ваша модель LLM формулирует этот результат на естественном языке.
Однако это не означает, что каждый ответ будет правильным. Генеративный ИИ по-прежнему может допускать ошибки, даже если вы предоставляете структурированные данные для решений на базе ИИ. Тем не менее, ключевые факты получаются в результате понятного запроса, а не на основе оценки схожести.
При этом решение no-code (No-Code) даёт организационное преимущество для вашего управления знаниями на основе ИИ: специализированные подразделения самостоятельно создают и поддерживают модели данных и процессы, не делегируя никаких изменений ИТ-отделу.
Векторизация против структурирования: системам RAG требуется гибридная структура #
Прежде всего, вопрос о том, что выбрать — векторизацию или структурирование, — не является жёстким выбором «или-или». Векторизация выявляет сходства в значениях; структурирование позволяет явно запрашивать факты и связи. Эффективная современная система RAG должна сочетать в себе оба этих принципа. Если ваша внутренняя база знаний уже предоставляет информацию в структурированном виде, системы RAG дают более детерминированные результаты, чем в том случае, когда данные и информация сначала должны быть отфильтрованы и структурированы через API. Поэтому вам следует хранить структурированную основную информацию в реляционной базе данных. Документы можно хранить в подходящих системах управления контентом; например, это может быть та же самая реляционная база данных, если она подходит для этих целей.
| Требование | Подходящий тип доступа | Пример |
|---|---|---|
| Семантическое сходство | Векторный поиск | Поиск похожих обращений в службу поддержки |
| Точное условие | SQL или отфильтрованный API | Действующие договоры по определенному тарифу |
| Перечисление связей | Реляционная связь | Присвоение заявок соответствующим клиентам |
| Агрегация | Запрос к базе данных | Подсчёт критических заявок по каждому сегменту клиентов |
| Свободный поиск по документам | Гибридный поиск | Поиск соответствующих руководящих принципов или фрагментов текста |
Компоненты RAG LLM получают семантические фрагменты, когда решающее значение имеет смысл, и структурированные результаты запросов, когда речь идет о фактах и вычислениях. Фильтрация по метаданным сужает пространство поиска, например, по языку, статусу, типу документа или дате создания. Благодаря этому для RAG AI формируются более короткие контексты и обеспечивается контролируемость затрат.
Сервер MCP и ИИ-агенты: современная архитектура для корпоративного поиска #
Протокол Model Context Protocol стандартизирует взаимодействие между ИИ-приложениями и внешними ресурсами или инструментами. В архитектуре MCP хост управляет отдельными клиентами, каждый из которых подключён к серверу MCP. Ваш ИИ-агент с архитектурой RAG обнаруживает через сервер MCP соответствующие базы данных и выполняет целевой запрос. Система RAG загружает только необходимые строки или фрагменты документов и, при наличии предоставленных вами полномочий, также выполняет такие действия, как обновления или изменения.
Однако MCP сам по себе не обеспечивает автоматического формирования правильных ответов или безопасного доступа. Ваш сервер должен предоставлять подходящие, чётко ограниченные системы; хост должен контролировать разрешения, политики и подключения. Только так статическое управление знаниями на основе ИИ превращается в динамическое взаимодействие с операционными системами для контролируемой поддержки процессов.
SeaTable как единый источник достоверной информации для управления знаниями на основе ИИ #
SeaTable — это современная база данных ИИ no-code, в которой особое внимание уделяется гибкости, взаимодействию и максимальной защите данных. В архитектуре RAG AI, описанной выше, SeaTable отвечает за структурированный уровень знаний. Таблицы, типизированные столбцы и ссылки отображают сущности и связи. С помощью столбцов ссылок вы можете моделировать отношения 1:n, n:1 и n:m. Это позволяет вам вести структурированные данные для управления знаниями в области ИИ в более тесной привязке к бизнес-процессам, чем в случае использования чисто векторного текстового индекса. Детальные права доступа и редактирования непосредственно в базе данных способствуют обеспечению соответствия нормативным требованиям и надлежащего управления.
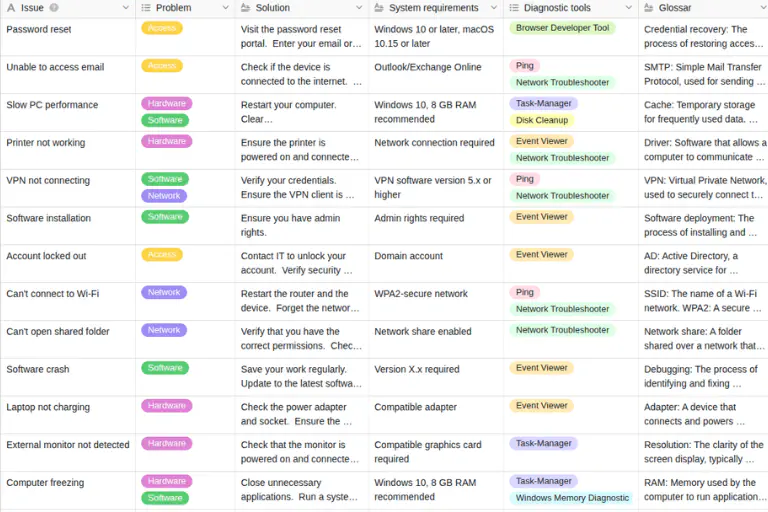
Сервер SeaTable MCP соединяет ИИ-помощников, поддерживающих MCP, с общей базой данных. Таким образом, ваша система RAG может целенаправленно извлекать актуальные наборы данных вместо того, чтобы регулярно заново векторизировать полные экспорты. Сервер SeaTable MCP, как и вся инфраструктура SeaTable, размещён на серверах европейских компаний в Германии. Компании с особо высокими требованиями к защите данных и соблюдению нормативных требований могут также разместить SeaTable и сервер SeaTable MCP на собственных серверах. Таким образом, SeaTable в вашей архитектуре RAG AI выполняет роль единого источника достоверной информации (Single Source of Truth) для изменяемых реляционных данных.
Управление данными LLM: внедрение безопасности и контроля доступа в компании #
Продуктивная архитектура агентов должна давать ответы на те же основные вопросы, что и другие корпоративные системы: Кто имеет право читать, изменять или экспортировать какие данные и с какой целью? Таким образом, управление данными LLM начинается с классификации данных и идентификации пользователей, а не с самого запроса.
Для каждой системы RAG следует определить как минимум следующие меры контроля:
-
единый источник данных и ответственного владельца данных для каждого объекта,
-
правила доступа, основанные на ролях или атрибутах,
-
раздельные права на чтение и запись в соответствии с принципом минимальных привилегий,
-
фильтрация перед извлечением данных, а не после вывода результатов модели,
-
журналы запросов, источников, вызовов инструментов и изменений,
-
управление версиями, концепции удаления и определённые сроки хранения,
-
тестирование на уязвимости к «промпт-инъекции», утечке данных и недопустимым действиям,
-
Утверждение с участием человека (Human-in-the-Loop) для необратимых или критически важных с точки зрения безопасности действий.
Система RAG не должна получать доступ к чужим данным путём простого угадывания идентификатора. Поэтому права доступа должны всегда обеспечиваться как на уровне базы данных, так и в системе RAG. Кроме того, благодаря целенаправленному поиску вы укрепляете контроль над затратами. Фильтрация метаданных и структурированные запросы сокращают количество нерелевантных входных токенов, а кэширование может снизить затраты на повторное использование контекста.
Вывод: структурированные данные как основа управления знаниями с помощью ИИ #
Надежное управление знаниями с помощью ИИ начинается со структурированной базы данных, не требующей программирования. Являясь «единым источником достоверной информации» (Single Source of Truth), она служит фундаментом, на котором система RAG может предоставлять точные ответы. Таблицы, определённые поля и связи явно отображают взаимосвязи. Агентам ИИ больше не нужно восстанавливать их из фрагментов текста.
Через сервер MCP агенты получают контролируемый доступ к этим данным, фильтруют их по метаданным и извлекают только релевантные записи. Это повышает точность, снижает потребление токенов и укрепляет управление данными LLM, поскольку права доступа привязаны к модели данных.
Это не предотвращает галлюцинации полностью, поскольку LLM по-прежнему формулирует ответы с учётом вероятности. Однако факты остаются воспроизводимыми и поддаются проверке. Поэтому тем, кто внедряет ИИ-агентов в своей компании, следует в первую очередь создать структурированную базу данных.
Часто задаваемые вопросы — управление знаниями с помощью ИИ #
Почему одной векторной базы данных зачастую недостаточно для системы RAG?
Как сервер MCP улучшает интеграцию баз данных no-code с агентами ИИ?
Какую роль играет база данных no-code в управлении знаниями с использованием ИИ в компаниях?
Снижает ли система RAG мои затраты на LLM?
В чём заключается преимущество детерминированных ответов ИИ в корпоративной среде?
TAGS: Цифровая Трансформация Управление Данными И Визуализация ИТ-Процессы