Cómo RAG está transformando la recuperación de conocimiento #
Los agentes de IA no solo deben encontrar el conocimiento de la empresa, sino también traducirlo de forma fiable en decisiones y acciones. Para ello, rara vez basta con vectorizar páginas de wiki y enviar los fragmentos de texto más similares a un LLM. Un sistema RAG productivo necesita, además de la búsqueda semántica, una base de datos en la que las entidades, las relaciones, los estados y las reglas de acceso se conserven y sigan siendo reconocibles para la IA.
Aspectos clave: #
-
Las limitaciones de los datos no estructurados: por qué las bases de datos vectoriales y las herramientas orientadas al texto, como Notion, Obsidian o Confluence, pueden contribuir a la pérdida de contexto en el caso de agentes de IA complejos.
-
La estructura como factor de calidad: cómo, mediante bases de datos estructuradas no-code como única fuente de verdad (Single Source of Truth), puede facilitar consultas precisas y respuestas de IA ampliamente reproducibles.
-
La arquitectura del futuro: qué funciones desempeñan la generación aumentada por recuperación, los agentes de IA y los servidores MCP (Model Context Protocol) en la gestión del conocimiento de IA de su empresa.
-
Control de costes y datos: Cómo mejorar la gobernanza y el control de costes mediante el filtrado de metadatos, la recuperación selectiva y una mayor eficiencia de tokens.
¿Qué significa RAG? #
La abreviatura RAG significa «Retrieval-Augmented Generation» y hace referencia a un patrón específico para conectar modelos de lenguaje con fuentes de conocimiento externas, como las bases de datos empresariales. En lugar de recurrir exclusivamente al conocimiento de entrenamiento, el sistema RAG busca en primer lugar información relevante y la transmite como contexto al modelo de IA utilizado. Este principio ha convertido a RAG AI en un componente fundamental de los asistentes empresariales actuales y específicos de cada ámbito. La búsqueda vectorial permite buscar contenidos semánticamente similares en grandes bases de datos y reducir considerablemente el contexto que se procesa realmente.
Para las empresas, esto significa que no tienen que volver a entrenar sus modelos de lenguaje cada vez que se produce un cambio en los documentos internos. En su lugar, una gestión del conocimiento con IA RAG moderna consulta fuentes actualizadas y proporciona conocimientos especializados de forma dinámica. De este modo, la documentación pasiva se convierte potencialmente en los denominados datos procesables, sobre cuya base los agentes de IA RAG activan otras herramientas o inician procesos.
El punto débil de los sistemas clásicos #
Sin embargo, la calidad de un sistema RAG depende en gran medida de qué datos se recopilan y de cómo funcionan la segmentación en fragmentos y la indexación. A menudo, los sistemas tratan casi todo el conocimiento almacenado de la misma manera: El contenido se extrae, se divide en fragmentos —es decir, en unidades más pequeñas—, se vectoriza y se almacena en una base de datos RAG. Este procedimiento funciona bien para preguntas concretas que buscan formulaciones similares o fragmentos de texto adecuados. Sin embargo, en cuanto formule una pregunta más compleja, para la que su agente de IA deba recurrir a relaciones de varios niveles entre los datos, filtros exactos o agregaciones, resulta más difícil obtener, en una configuración de este tipo, respuestas de IA deterministas y fiables.
Es cierto que, dependiendo del proveedor, puede realizar filtrados y agregaciones limitados a través de una API. Sin embargo, esto solo resuelve en parte el problema de la falta de relaciones y usted queda dependiente de la calidad del filtrado de la API. Además, el uso de una API conlleva en algunos casos costes adicionales; costes innecesarios, ya que también puede realizar las mismas consultas directamente en una base de datos de conocimiento relacional.
Bases de datos vectoriales: Fuertes en similitud, débiles en precisión #
Las bases de datos vectoriales, como Pinecone y Chroma, almacenan representaciones vectoriales (embeddings) y están optimizadas para detectar rápidamente similitudes entre fragmentos. Sin embargo, esto no significa que carezcan de estructura. Además de vectores, también pueden gestionar identificadores, textos y metadatos. No obstante, una desventaja de las bases de datos vectoriales típicas es que no modelan automáticamente la integridad referencial.
Tomemos como ejemplo una configuración típica de CRM. Un sistema RAG clásico puede, por ejemplo, responder a la siguiente pregunta utilizando una base de datos vectorial: «¿Qué solicitudes de asistencia se asemejan a este ticket?». Una pregunta para la que, sin embargo, es necesario reunir de forma contextualizada diversa información, como por ejemplo: «¿Qué clientes activos del país X con una facturación anual superior a Y han presentado un ticket de asistencia en los últimos 12 meses?»., por el contrario, requiere vínculos y filtros precisos, para lo cual es necesario combinar el sistema RAG con una base de conocimientos SQL.
Notion, Obsidian y Confluence: eliminan el caos documental, pero no ofrecen datos estructurados #
Tampoco los sistemas basados en Markdown o en bloques, como Obsidian, Notion o Confluence, son intrínsecamente no estructurados. Es más preciso hablar de sistemas semiestructurados:
-
Las bases de datos de Notion admiten propiedades tipificadas
-
Obsidian admite propiedades basadas en YAML
-
Confluence puede almacenar propiedades JSON
Como base para la gestión del conocimiento mediante IA en su empresa, estos sistemas solo son adecuados de forma limitada debido a su estructura basada en páginas. A menudo se siguen utilizando como una mera recopilación de páginas, a modo de wiki empresarial con metadatos ausentes, lógicas de nomenclatura dispares, propiedades inconsistentes y entradas duplicadas. Si basa la gestión del conocimiento en IA en un sistema de este tipo, el caos habitual de una wiki no desaparece ni se estructura de repente. Simplemente se vuelve semánticamente consultable.
El problema de la pérdida de contexto: por qué los modelos de lenguaje grande (LLM) pueden «alucinar» sin una estructura de datos clara #
¿Por qué supone un problema la falta de contexto? Al procesar documentos o bases de datos de conocimiento internas, la estructura puede perderse en varios puntos. El principal factor de riesgo en las bases de datos no estructuradas o semiestructuradas es la denominada transformación con pérdida: un documento fuente o una información se divide en fragmentos, cada fragmento se vectoriza por separado y, en consultas posteriores, se utiliza principalmente en función de la similitud semántica con la tarea en cuestión. Las tablas se convierten en texto, los encabezados se separan de la sección correspondiente, se atenúan las conexiones entre afirmaciones relacionadas y los vínculos entre objetos se reducen a meras palabras. Si, posteriormente, su sistema RAG solo encuentra fragmentos aislados, es posible que el RAG transmita al LLM afirmaciones que, en sí mismas, sean correctas. Sin embargo, se pierde el contexto que limita su validez.
Un ejemplo: tiene clientes en distintas regiones con condiciones contractuales diferentes. Sin un contexto completo, un agente puede recuperar información objetivamente correcta que, sin embargo, no sea aplicable a la ubicación en cuestión o al cliente concreto debido a factores específicos.
La pérdida de contexto puede producirse en varios puntos:
-
Ingest: las tablas, propiedades, enlaces o jerarquías de bloques se reducen a texto continuo.
-
Chunking: la información relacionada acaba en fragmentos distintos
-
Incrustación: se representa la similitud de significado, pero no se representan automáticamente las relaciones lógicas o causales.
-
Recuperación: una búsqueda puramente vectorial encuentra pasajes semánticamente similares, pero no necesariamente toda la información relevante.
-
Prompting: No se proporcionan metadatos ni relaciones, o bien los contenidos relevantes se pierden en un contexto demasiado extenso.
Por qué las ventanas de contexto más amplias no evitan la pérdida de contexto #
Para prevenir las alucinaciones o los errores de recuperación, puede proporcionar a la IA el mayor contexto posible en la consulta. Sin embargo, esta no es una solución fiable. Y es que, con ventanas de contexto más amplias, aumenta el denominado «riesgo de pérdida en el medio». Las investigaciones demuestran que, dependiendo de su posición en ventanas de contexto largas, la información puede utilizarse con diferente grado de fiabilidad. Además, se ha observado con frecuencia una disminución del rendimiento simplemente por el hecho de que las entradas sean más largas.
Por lo tanto, incluir tanta información como sea posible —o incluso documentos completos— en la solicitud no solo empeora su eficiencia de tokens, sino que también puede generar más distracciones cuando el modelo de lenguaje grande (LLM) tiene que procesar gran cantidad de información. Los costes suelen aumentar con el número de tokens procesados —aunque no de forma automáticamente exponencial—, ya que los proveedores de API facturan los tokens de entrada y salida por volumen. La optimización de la recuperación de conocimiento consiste, en cambio, en proporcionar el menor contexto posible, pero que sea totalmente relevante.
¿Qué ventajas ofrecen las bases de datos estructuradas, relacionales y no-code para el RAG? #
Una base de datos estructurada, relacional y no-code puede, por ejemplo, almacenar información de clientes, productos, activos o contratos en tablas independientes. Los enlaces entre las tablas representan las relaciones, y los tipos de datos unívocos y los campos obligatorios reducen la ambigüedad. De este modo se generan datos estructurados y contextualizados que su agente de IA puede filtrar, ordenar, relacionar y agregar, en lugar de tener que adivinar las conexiones a partir de fragmentos de texto.
Esta arquitectura de datos es la que permite obtener respuestas de IA deterministas, es decir, reproducibles: su consulta a la base de datos ofrece el mismo resultado con un estado de datos y unas condiciones idénticas. Su LLM formula este resultado en lenguaje natural.
Sin embargo, esto no significa que todas las respuestas sean correctas. La IA generativa puede seguir cometiendo errores, incluso si proporciona datos estructurados para soluciones de IA. No obstante, los datos críticos proceden de una consulta verificable y no de una estimación de similitud.
En este sentido, una solución «no-code» supone una ventaja organizativa para su gestión del conocimiento basada en IA: Los departamentos especializados crean y mantienen ellos mismos los modelos de datos y los procesos, sin tener que delegar cada cambio al departamento de TI.
Vectorización frente a estructuración: los sistemas RAG necesitan una estructura híbrida #
En primer lugar, la cuestión de la vectorización o la estructuración no es una disyuntiva absoluta. La vectorización permite identificar similitudes de significado; la estructuración le permite consultar de forma explícita hechos y relaciones. Un sistema RAG eficaz y moderno debería combinar ambos principios. Si su base de datos de conocimiento interna ya proporciona la información de forma estructurada, los sistemas RAG obtienen resultados más deterministas que cuando los datos y la información deben filtrarse y estructurarse primero a través de la API. Por lo tanto, debería almacenar la información básica estructurada en una base de datos relacional. Puede almacenar los documentos en sistemas de contenido adecuados; por ejemplo, puede ser la misma base de datos relacional, si resulta adecuada para ello.
| Requisito | Tipo de acceso adecuado | Ejemplo |
|---|---|---|
| Similitud semántica | Búsqueda vectorial | Encontrar casos de asistencia similares |
| Condición exacta | SQL o API filtrada | Contratos activos de una tarifa |
| Listado de relaciones | Enlace relacional | Asignar tickets al cliente correcto |
| Agregación | Consulta de base de datos | Contar los tickets críticos por segmento de clientes |
| Consulta libre de documentos | Búsqueda híbrida | Encontrar directrices o fragmentos de texto adecuados |
Los componentes RAG LLM reciben fragmentos semánticos cuando el significado es decisivo, y resultados de consulta estructurados cuando se trata de hechos y cálculos. El filtrado de metadatos reduce el espacio de búsqueda, por ejemplo, por idioma, estado, tipo de documento o fecha de creación. De este modo, se generan contextos más breves para la IA de RAG y se mantienen los costes bajo control.
Servidor MCP y agentes de IA: la arquitectura moderna para la búsqueda empresarial #
El Model Context Protocol estandariza la conexión entre aplicaciones de IA y recursos o herramientas externos. En la arquitectura MCP, un host gestiona clientes individuales, cada uno de los cuales está conectado a un servidor MCP. Su agente de IA con arquitectura RAG detecta las bases de datos relevantes a través de un servidor MCP y realiza una consulta específica. El sistema RAG solo carga las líneas o fragmentos de documentos necesarios y, siempre que usted le conceda la autorización para ello, también lleva a cabo acciones como actualizaciones o modificaciones.
Sin embargo, el MCP por sí solo no genera automáticamente respuestas correctas ni accesos seguros. Su servidor debe proporcionar sistemas adecuados y claramente delimitados; el host debe controlar las autorizaciones, las directrices y las conexiones. Solo así la gestión del conocimiento estática basada en IA se convierte en una interacción dinámica con los sistemas operativos para un apoyo controlado de los procesos.
SeaTable como «fuente única de verdad» para la gestión del conocimiento basada en IA #
SeaTable es una moderna base de datos de IA no-code con un fuerte enfoque en la flexibilidad, la interoperabilidad y la máxima protección de datos. En una arquitectura RAG de IA como la descrita anteriormente, SeaTable se encarga de la capa de conocimiento estructurado. Las tablas, las columnas tipificadas y los enlaces representan entidades y relaciones. Mediante columnas de enlace, puede modelar relaciones 1:n, n:1 y n:m. De este modo, podrá gestionar datos estructurados para su gestión del conocimiento de IA de forma más cercana a los procesos de negocio que en un índice de texto puramente basado en vectores. Los derechos granulares de acceso y edición en la propia base de datos favorecen el cumplimiento normativo y la gobernanza.
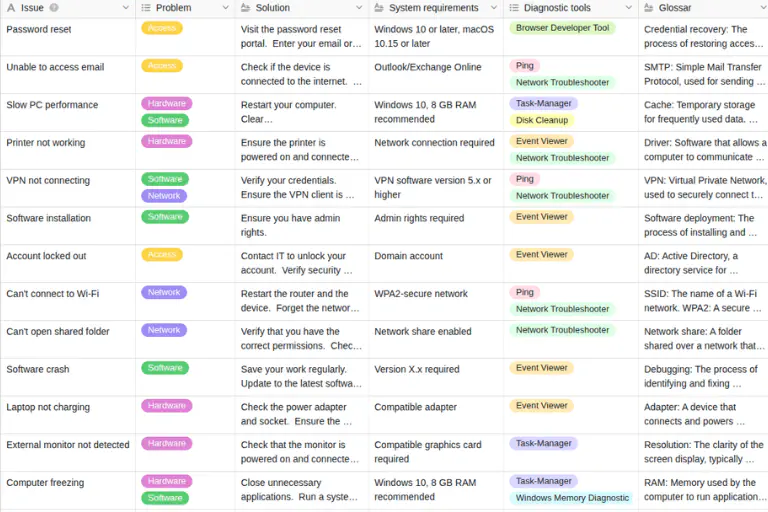
El servidor SeaTable MCP conecta los asistentes de IA compatibles con MCP a una base de datos compartida. De este modo, su sistema RAG puede recuperar de forma selectiva registros de datos actuales, en lugar de tener que volver a vectorizar periódicamente exportaciones completas. El servidor SeaTable MCP, al igual que toda la infraestructura de SeaTable, se aloja en servidores de empresas europeas ubicadas en Alemania. Las empresas con requisitos especialmente exigentes en materia de protección de datos y cumplimiento normativo también pueden alojar SeaTable y el servidor SeaTable MCP de forma local. De este modo, SeaTable asume en su arquitectura RAG AI el papel de «fuente única de verdad» para datos relacionales y variables.
Gobernanza de datos LLM: integrar la seguridad y el control de acceso en la empresa #
Una arquitectura de agentes productiva debe responder a las mismas preguntas fundamentales que cualquier otro sistema empresarial: ¿Quién puede leer, modificar o exportar qué datos y con qué finalidad? Por lo tanto, la gobernanza de datos de los LLM comienza por la clasificación de datos y las identidades, y no solo a partir del prompt.
Para cada sistema RAG deben definirse, como mínimo, los siguientes controles:
-
una fuente principal y un propietario de datos responsable por cada entidad,
-
reglas de acceso basadas en roles o atributos,
-
derechos de lectura y escritura separados según el principio del privilegio mínimo,
-
filtrado previo a la recuperación, en lugar de tras la salida del modelo,
-
registros de consultas, fuentes, llamadas a herramientas y modificaciones,
-
control de versiones, políticas de eliminación y plazos de conservación definidos,
-
Pruebas contra la inyección de comandos, la fuga de datos y las acciones no permitidas,
-
Autorizaciones «human-in-the-loop» para pasos irreversibles o críticos para la seguridad.
Un sistema RAG no debe poder acceder a datos ajenos mediante la mera conjetura de un identificador. Por lo tanto, los permisos deben aplicarse siempre tanto a nivel de la base de datos como en el sistema RAG. Además, mediante una recuperación selectiva, se refuerza el control de costes. El filtrado de metadatos y las consultas estructuradas reducen los tokens de entrada irrelevantes, y el almacenamiento en caché puede abaratar el contexto recurrente.
Conclusión: los datos estructurados como base para la gestión del conocimiento con IA #
Una gestión del conocimiento con IA fiable comienza con una base de datos estructurada no-code. Como «fuente única de verdad», constituye la base sobre la que un sistema RAG puede ofrecer respuestas exactas. Las tablas, los campos definidos y las relaciones hacen explícitas las conexiones. Los agentes de IA ya no tienen que reconstruirlas a partir de fragmentos de texto.
A través de un servidor MCP, los agentes acceden a estos datos de forma controlada, los filtran mediante metadatos y solo recuperan los registros relevantes. Esto aumenta la precisión, reduce el consumo de tokens y refuerza la gobernanza de datos de los LLM, ya que los derechos de acceso se aplican directamente al modelo de datos.
Esto no evita por completo las alucinaciones, ya que el LLM sigue formulando en función de la probabilidad. Sin embargo, los hechos son reproducibles y verificables. Por lo tanto, quien utilice agentes de IA en la empresa debería crear primero la base de datos estructurada.
Preguntas frecuentes: gestión del conocimiento con IA #
¿Por qué, a menudo, una base de datos vectorial por sí sola no es suficiente para un sistema RAG?
¿Cómo mejora un servidor MCP la conexión entre las bases de datos no-code y los agentes de IA?
¿Qué papel desempeña una base de datos no-code en la gestión del conocimiento basada en IA en las empresas?
¿Reduce un sistema RAG mis costes de LLM?
¿Cuál es la ventaja de las respuestas determinísticas de la IA en las empresas?
TAGS: Transformación Digital Gestión Y Visualización De Datos Procesos Informáticos