Comment le RAG transforme la recherche de connaissances #
Les agents d’IA ne doivent pas seulement trouver les connaissances de l’entreprise, mais aussi les traduire de manière fiable en décisions et en actions. Pour cela, il suffit rarement de vectoriser des pages Wiki et d’envoyer les extraits de texte les plus similaires à un LLM. Un système RAG productif nécessite, outre une recherche sémantique, une base de données dans laquelle les entités, les relations, les états et les règles d’accès sont conservés et restent identifiables par l’IA.
Points clés : #
-
Les limites des données non structurées : pourquoi les bases de données vectorielles et les outils orientés texte tels que Notion, Obsidian ou Confluence peuvent contribuer à une perte de contexte dans le cas d’agents IA complexes.
-
La structure comme facteur de qualité : comment, grâce à des bases de données structurées « no-code » servant de source unique de vérité, vous pouvez permettre des requêtes précises et des réponses d’IA largement reproductibles.
-
L’architecture du futur : quels rôles jouent la génération augmentée par la recherche (Retrieval-Augmented Generation), les agents IA et les serveurs MCP (Model Context Protocol) dans la gestion des connaissances IA de votre entreprise.
-
Maîtrise des coûts et des données : comment améliorer la gouvernance et la maîtrise des coûts grâce au filtrage des métadonnées, à la recherche ciblée et à une meilleure efficacité des tokens.
Que signifie RAG ? #
L’abréviation RAG signifie « Retrieval-Augmented Generation » et désigne un modèle spécifique permettant de relier des modèles linguistiques à des sources de connaissances externes, telles que les bases de données d’entreprise. Au lieu de s’appuyer exclusivement sur les connaissances acquises lors de l’entraînement, le système RAG recherche d’abord les informations pertinentes et les transmet sous forme de contexte au modèle d’IA utilisé. Ce principe a fait de RAG AI un élément central des assistants d’entreprise actuels, spécialisés dans un domaine spécifique. La recherche vectorielle permet de rechercher, au sein de vastes bases de données, des contenus sémantiquement similaires et de réduire considérablement le contexte effectivement traité.
Pour les entreprises, cela signifie qu’elles n’ont pas besoin de réentraîner leurs modèles linguistiques à chaque modification des documents internes. Une gestion moderne des connaissances par IA RAG consulte plutôt des sources actualisées et met à disposition de manière dynamique des connaissances spécialisées. La documentation passive se transforme ainsi potentiellement en ce que l’on appelle des données exploitables, sur la base desquelles les agents IA RAG peuvent activer d’autres outils ou déclencher des processus.
La faiblesse des systèmes classiques #
La qualité d’un système RAG dépend toutefois très fortement des données qui sont exploitées et de la manière dont le découpage en segments et l’indexation fonctionnent. Souvent, les systèmes traitent de la même manière la quasi-totalité des connaissances stockées : le contenu est extrait, décomposé en chunks – c’est-à-dire en unités plus petites –, vectorisé, puis stocké dans une base de données RAG. Cette approche fonctionne bien pour les questions précises qui recherchent des formulations similaires ou des extraits de texte correspondants. Cependant, dès que vous posez une question plus complexe, pour laquelle votre agent IA doit faire appel à des relations à plusieurs niveaux entre les données, à des filtres précis ou à des agrégations, il devient plus difficile, dans une telle configuration, d’obtenir des réponses IA fiables et déterministes.
Certes, selon le fournisseur, vous pouvez effectuer des filtrages et des agrégations limités via une API. Cependant, cela ne résout que partiellement le problème de l’absence de relations et vous dépendez de la qualité du filtrage de l’API. De plus, l’utilisation d’une API entraîne parfois des coûts supplémentaires ; des coûts inutiles, puisque vous pouvez effectuer les mêmes requêtes directement dans une base de connaissances relationnelle.
Bases de données vectorielles : Performantes en matière de similarité, moins performantes en matière de précision #
Les bases de données vectorielles telles que Pinecone et Chroma stockent des embeddings et sont optimisées pour détecter rapidement les similarités entre les chunks. Cela ne signifie toutefois pas qu’elles sont dépourvues de structure. Outre les vecteurs, elles peuvent également gérer des identifiants, des textes et des métadonnées. L’un des inconvénients des bases de données vectorielles classiques réside toutefois dans le fait qu’elles ne modélisent pas automatiquement les intégrités référentielles.
Prenons l’exemple d’un environnement CRM classique. À l’aide d’une base de données vectorielle, un système RAG classique peut par exemple répondre à la question suivante : « Quelles demandes d’assistance sont similaires à ce ticket ? ». Une question qui nécessite toutefois de regrouper différentes informations dans leur contexte, comme par exemple : « Quels clients actifs du pays X, dont le chiffre d’affaires annuel est supérieur à Y, ont soumis un ticket d’assistance au cours des 12 derniers mois ? », nécessite en revanche des liens et des filtres précis, pour lesquels le système RAG doit être associé à une base de connaissances SQL.
Notion, Obsidian et Confluence : ils éliminent le chaos documentaire, mais ne fournissent pas de données structurées #
Même les systèmes basés sur Markdown ou sur des blocs, tels qu’Obsidian, Notion ou Confluence, ne sont pas fondamentalement non structurés. Il est plus précis de parler de systèmes semi-structurés :
-
Les bases de données Notion prennent en charge les propriétés typées
-
Obsidian prend en charge les propriétés basées sur YAML
-
Confluence peut stocker des propriétés JSON
En tant que base pour la gestion des connaissances par IA au sein de votre entreprise, ces systèmes ne sont que partiellement adaptés en raison de leur structure basée sur des pages. Souvent, ils sont encore utilisés comme de simples recueils de pages, à la manière d’un wiki d’entreprise, avec des métadonnées manquantes, des logiques de nommage disparates, des propriétés incohérentes et des entrées en double. Si vous mettez en place une gestion des connaissances basée sur l’IA sur un tel système, le chaos habituel du wiki ne disparaîtra pas et ne deviendra pas soudainement structuré. Il deviendra simplement consultable sur le plan sémantique.
Le problème de la perte de contexte : pourquoi les LLM peuvent « halluciner » en l’absence de structure de données claire #
Pourquoi l’absence de contexte constitue-t-elle un problème ? Lors du traitement de documents ou de bases de données de connaissances internes, la structure peut se perdre à plusieurs niveaux. Le principal facteur de risque lié aux bases de données non structurées ou semi-structurées est ce qu’on appelle la transformation avec perte : un document source ou une information est décomposé en morceaux, chaque morceau est vectorisé séparément et, lors de requêtes ultérieures, il est principalement utilisé en fonction de sa similitude sémantique avec la tâche à accomplir. Les tableaux sont transformés en texte, les titres sont séparés de la section à laquelle ils se rapportent, les liens entre des affirmations apparentées sont affaiblis et les relations entre les objets sont réduites à de simples mots. Si votre système RAG ne trouve ensuite que des segments isolés, il est possible que le RAG transmette au LLM des énoncés corrects. Le contexte, qui limite leur validité, est toutefois perdu.
Un exemple : vous avez des clients dans différentes régions avec des conditions contractuelles variées. Sans contexte complet, un agent peut extraire une information factuellement correcte, mais qui ne s’applique pas au site concerné ou au client en question en raison de facteurs particuliers.
Les pertes de contexte peuvent survenir à plusieurs niveaux :
-
Ingestion : les tableaux, les propriétés, les liens ou les hiérarchies de blocs sont réduits à du texte continu.
-
Segmentation : des informations apparentées se retrouvent dans des segments différents
-
Intégration : la similitude sémantique est représentée, mais pas automatiquement les liens logiques ou causaux.
-
Récupération : une recherche vectorielle pure trouve des passages sémantiquement similaires, mais pas nécessairement toutes les informations pertinentes.
-
Prompting : les métadonnées et les relations ne sont pas fournies, ou les contenus pertinents se perdent dans un contexte trop long.
Pourquoi des fenêtres de contexte plus larges n’empêchent pas la perte de contexte #
Pour prévenir les hallucinations ou les erreurs de récupération, vous pouvez fournir à l’IA autant de contexte que possible dans la requête. Ce n’est toutefois pas une solution fiable. En effet, avec des fenêtres de contexte plus larges, le risque dit « Lost in the Middle » augmente. Des recherches montrent que la fiabilité d’utilisation des informations varie en fonction de leur position dans de longues fenêtres de contexte. De plus, des baisses de performances ont régulièrement été observées simplement en raison de la longueur des entrées.
Charger un maximum d’informations, voire des documents entiers, dans la requête ne se contente donc pas de nuire à votre efficacité en termes de tokens. Cela peut également générer davantage de distractions lorsque le LLM doit traiter un volume important d’informations. Les coûts augmentent généralement avec le nombre de tokens traités – pas nécessairement de manière exponentielle –, car les fournisseurs d’API facturent les tokens d’entrée et de sortie au volume. L’optimisation de la recherche de connaissances consiste plutôt à fournir un contexte aussi restreint que possible, mais entièrement pertinent.
Quels sont les avantages des bases de données structurées, relationnelles et no-code pour le RAG ? #
Une base de données structurée, relationnelle et no-code peut, par exemple, gérer les informations clients, les produits, les actifs ou les contrats sous forme de tables distinctes. Les liens entre les tables reflètent les relations, tandis que des types de données uniques et des champs obligatoires réduisent les ambiguïtés. Il en résulte des données structurées et contextualisées que votre agent IA peut filtrer, trier, relier et agréger, au lieu de deviner des liens à partir de fragments de texte.
C’est cette architecture de données qui permet d’obtenir des réponses d’IA déterministes, c’est-à-dire reproductibles : votre requête de base de données fournit le même résultat lorsque l’état des données et les conditions sont identiques. Votre LLM formule ce résultat en langage naturel.
Cela ne signifie toutefois pas que chaque réponse soit correcte. L’IA générative peut toujours commettre des erreurs, même si vous fournissez des données structurées pour vos solutions d’IA. Les faits essentiels proviennent toutefois d’une requête traçable et non d’une estimation de similarité.
Dans ce contexte, une solution « no-code » constitue un avantage organisationnel pour votre gestion des connaissances basée sur l’IA : les services métier créent et gèrent eux-mêmes les modèles de données et les processus, sans devoir déléguer la moindre modification au service informatique.
Vectorisation vs structuration : les systèmes RAG ont besoin d’une structure hybride #
Tout d’abord, la question de la vectorisation ou de la structuration n’est pas un choix binaire. La vectorisation met en évidence les similitudes de sens ; la structuration vous permet d’interroger explicitement des faits et des relations. Un système RAG moderne et efficace doit combiner ces deux principes. Si votre base de connaissances interne fournit déjà des informations structurées, les systèmes RAG obtiennent des résultats plus déterministes que lorsque les données et les informations doivent d’abord être filtrées et structurées via l’API. C’est pourquoi vous devriez stocker les informations structurées essentielles dans une base de données relationnelle. Vous pouvez archiver les documents dans des systèmes de gestion de contenu adaptés ; il peut s’agir, par exemple, de cette même base de données relationnelle si elle est adaptée à cet usage.
| Exigence | Type d’accès adapté | Exemple |
|---|---|---|
| Similitude sémantique | Recherche vectorielle | Trouver des cas d’assistance similaires |
| Condition exacte | SQL ou API filtrée | Contrats actifs d’une offre tarifaire |
| Liste des relations | Liaison relationnelle | Attribuer les tickets au bon client |
| Agrégation | Requête de base de données | Compter les tickets critiques par segment de clientèle |
| Recherche libre dans des documents | Recherche hybride | Trouver les directives ou passages de texte pertinents |
Les composants RAG LLM reçoivent des segments sémantiques lorsque le sens est déterminant, et des résultats de requête structurés lorsqu’il s’agit de faits et de calculs. Le filtrage des métadonnées réduit l’espace de recherche, par exemple en fonction de la langue, du statut, du type de document ou de la date de création. Cela permet à l’IA RAG de disposer de contextes plus courts et de coûts maîtrisables.
Serveur MCP et agents IA : l’architecture moderne pour la recherche d’entreprise #
Le Model Context Protocol normalise la connexion entre les applications d’IA et les ressources ou outils externes. Dans l’architecture MCP, un hôte gère des clients individuels, chacun étant connecté à un serveur MCP. Votre agent IA doté d’une architecture RAG identifie les bases de données pertinentes via un serveur MCP et effectue une requête ciblée. Le système RAG ne charge que les lignes ou extraits de documents nécessaires et, sous réserve que vous lui en donniez l’autorisation, effectue également des actions telles que des mises à jour ou des modifications.
Cependant, le MCP ne génère pas à lui seul automatiquement des réponses correctes ni des accès sécurisés. Votre serveur doit mettre à disposition des systèmes adaptés et clairement délimités ; l’hôte doit contrôler les autorisations, les directives et les connexions. C’est seulement ainsi que la gestion statique des connaissances par IA se transforme en une interaction dynamique avec les systèmes opérationnels pour un soutien contrôlé des processus.
SeaTable, source unique de vérité pour la gestion des connaissances basée sur l’IA #
SeaTable est une base de données IA no-code moderne qui met fortement l’accent sur la flexibilité, l’interopérabilité et une protection maximale des données. Dans une architecture RAG IA telle que décrite ci-dessus, SeaTable prend en charge la couche de connaissances structurée. Les tableaux, les colonnes typées et les liens représentent des entités et des relations. Les colonnes de liens vous permettent de modéliser des relations 1:n, n:1 et n:m. Cela vous permet de gérer des données structurées pour votre gestion des connaissances en IA de manière plus proche des processus métier que dans un simple index textuel basé sur des vecteurs. Des droits d’accès et de modification granulaires au sein même de la base de données favorisent la conformité et la gouvernance.
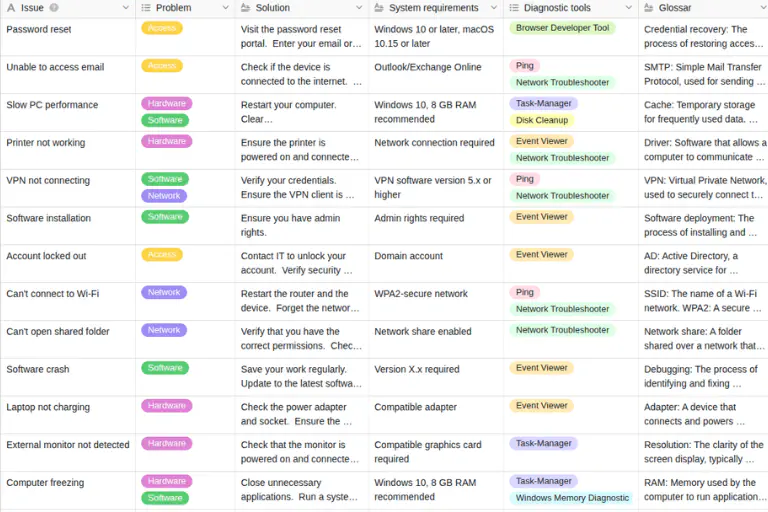
Le serveur SeaTable MCP relie les assistants IA compatibles MCP à une base de données partagée. Votre système RAG peut ainsi récupérer de manière ciblée des enregistrements de données à jour, au lieu de vectoriser régulièrement de nouvelles exportations complètes. À l’instar de l’ensemble de l’infrastructure SeaTable, le serveur SeaTable MCP est hébergé sur des serveurs d’entreprises européennes situés en Allemagne. Les entreprises soumises à des exigences particulièrement strictes en matière de protection des données et de conformité peuvent également héberger SeaTable et le serveur SeaTable MCP sur site. SeaTable endosse ainsi, au sein de votre architecture RAG IA, le rôle de « source unique de vérité » pour les données relationnelles évolutives.
Gouvernance des données LLM : ancrer la sécurité et le contrôle d’accès au sein de l’entreprise #
Une architecture d’agents productive doit répondre aux mêmes questions fondamentales que les autres systèmes d’entreprise : qui est autorisé à lire, modifier ou exporter quelles données et à quelles fins ? La gouvernance des données LLM commence donc par la classification des données et les identités, et non pas seulement au niveau de la requête.
Pour chaque système RAG, il convient de définir au minimum les contrôles suivants :
-
une source de référence et un propriétaire de données responsable pour chaque entité,
-
des règles d’accès basées sur les rôles ou les attributs,
-
des droits de lecture et d’écriture distincts selon le principe du privilège minimal,
-
un filtrage avant la récupération plutôt qu’après la sortie du modèle,
-
des journaux pour les requêtes, les sources, les appels d’outils et les modifications,
-
la gestion des versions, des stratégies de suppression et des délais de conservation définis,
-
des tests de protection contre l’injection de prompt, la fuite de données et les actions non autorisées,
-
des validations « human-in-the-loop » pour les étapes irréversibles ou critiques pour la sécurité.
Un système RAG ne doit pas pouvoir accéder à des données tierces par simple devinette d’un identifiant. C’est pourquoi les autorisations doivent toujours être appliquées tant au niveau de la base de données que dans le système RAG. Grâce à une recherche ciblée, vous renforcez en outre le contrôle des coûts. Le filtrage des métadonnées et les requêtes structurées réduisent les jetons d’entrée non pertinents, et la mise en cache peut rendre les contextes récurrents plus économiques.
Conclusion : les données structurées, fondement de la gestion des connaissances par l’IA #
Une gestion des connaissances par l’IA fiable commence par une base de données structurée no-code. En tant que « source unique de vérité », elle constitue le fondement sur lequel un système RAG peut fournir des réponses précises. Les tableaux, les champs définis et les liens rendent les relations explicites. Les agents IA n’ont plus besoin de les reconstituer à partir de fragments de texte.
Via un serveur MCP, les agents accèdent à ces données de manière contrôlée, les filtrent à l’aide de métadonnées et ne récupèrent que les enregistrements pertinents. Cela augmente la précision, réduit la consommation de tokens et renforce la gouvernance des données LLM, car les droits d’accès s’appliquent au niveau du modèle de données.
Cela n’empêche pas totalement les hallucinations, car le LLM continue de formuler ses réponses en fonction de probabilités. Cependant, les faits sont reproductibles et vérifiables. Quiconque utilise des agents IA au sein de son entreprise devrait donc commencer par créer une base de données structurée.
FAQ – Gestion des connaissances avec l’IA #
Pourquoi une base de données vectorielle ne suffit-elle souvent pas à elle seule pour un système RAG ?
Comment un serveur MCP améliore-t-il la connexion entre les bases de données « no-code » et les agents IA ?
Quel rôle joue une base de données « no-code » dans la gestion des connaissances par IA au sein des entreprises ?
Un système RAG réduit-il mes coûts liés aux LLM ?
Quel est l’avantage des réponses déterministes issues de l’IA en entreprise ?
TAGS: Transformation Numérique Gestion Des Données & Visualisation Processus Informatiques