Wie RAG das Knowledge Retrieval verändert #
KI-Agenten sollen Unternehmenswissen nicht nur finden, sondern zuverlässig in Entscheidungen und Aktionen übersetzen. Dafür genügt es selten, Wiki-Seiten zu vektorisieren und die ähnlichsten Textabschnitte an ein LLM zu senden. Ein produktives RAG-System braucht neben semantischer Suche eine Datenbasis, in der Entitäten, Beziehungen, Zustände und Zugriffsregeln erhalten und für die KI erkennbar bleiben.
Key-facts: #
-
Die Grenzen unstrukturierter Daten: Warum Vektordatenbanken und textorientierte Tools wie Notion, Obsidian oder Confluence bei komplexen KI-Agenten zu Kontextverlust beitragen können.
-
Struktur als Qualitätsfaktor: Wie Sie mit strukturierten No-Code-Datenbanken als Single Source of Truth präzise Abfragen und weitgehend reproduzierbare KI-Antworten ermöglichen.
-
Architektur der Zukunft: Welche Rollen Retrieval-Augmented Generation, KI-Agenten und MCP-Server (Model Context Protocol) im KI Wissensmanagement Ihres Unternehmens übernehmen.
-
Kosten- und Datenkontrolle: Wie Sie mit Metadaten-Filtering, gezieltem Retrieval und einer höheren Token-Effizienz Governance und Kostenkontrolle verbessern.
Was bedeutet RAG? #
Die Abkürzung RAG steht für Retrieval-Augmented Generation und bezeichnet ein spezifisches Muster, um Sprachmodelle mit externen Wissensquellen wie Unternehmensdatenbanken zu verbinden. Statt ausschließlich auf Trainingswissen zurückzugreifen, sucht das RAG-System zunächst relevante Informationen und übergibt sie als Kontext an das genutzte KI-Modell. Dieses Prinzip hat RAG AI zu einem zentralen Baustein für aktuelle, domänenspezifische Unternehmensassistenten gemacht. Vektorsuche kann dabei in großen Datenbänken nach semantisch ähnlichen Inhalten suchen und den tatsächlich verarbeiteten Kontext deutlich verkleinern.
Für Unternehmen bedeutet dies, dass sie ihre Sprachmodelle nicht nach jeder Änderung von internen Dokumenten neu trainieren müssen. Ein modernes RAG KI Wissensmanagement ruft stattdessen aktuelle Quellen ab und stellt fachliches Wissen dynamisch bereit. Aus passiver Dokumentation entsteht damit potenziell sogenannte Actionable Data, auf deren Basis RAG KI-Agenten weitere Werkzeuge aufrufen oder Prozesse anstoßen.
Die Schwachstelle klassischer Systeme #
Die Qualität eines RAG-Systems hängt jedoch in ganz starkem Maße davon ab, welche Daten überhaupt erschlossen werden und wie das Chunking und die Indexierung funktioniert. Häufig behandeln Systeme nahezu jedes gespeicherte Wissen gleich: Der Inhalt wird extrahiert, in Chunks – also in kleinere Einheiten – zerlegt, vektorisiert und in einer RAG Datenbank gespeichert. Dieses Vorgehen funktioniert gut für enge Fragen, die nach ähnlichen Formulierungen oder passenden Textabschnitten suchen. Sobald Sie jedoch eine komplexere Frage stellen, für die Ihr KI-Agent mehrstufige Beziehungen zwischen Daten, exakte Filter oder Aggregationen heranziehen muss, wird es in solch einem Setup schwieriger, belastbare, deterministische KI-Antworten zu erhalten.
Zwar können Sie je nach Anbieter über eine API begrenzte Filterungen und Aggregationen durchführen. Das Problem der fehlenden Relationen wird dadurch jedoch nur bedingt beseitigt und Sie sind von der Qualität der API-Filterung abhängig. Zudem ist eine API-Nutzung teilweise mit zusätzlichen Kosten verbunden; unnötigen Kosten, da Sie dieselben Abfragen auch direkt in einer relationalen Wissensdatenbank durchführen können.
Vektordatenbanken: Stark für Ähnlichkeit, schwach bei Exaktheit #
Vektordatenbanken wie Pinecone und Chroma speichern Embeddings und sind dafür optimiert, schnell Ähnlichkeiten zwischen Chunks zu erkennen. Dies bedeutet indes nicht, dass sie strukturlos sind. Neben Vektoren können sie auch IDs, Texte und Metadaten verwalten. Ein Nachteil von typischen Verkordatenbanken ist jedoch, dass sie referenzielle Integritäten nicht automatisch modellieren.
Nehmen wir als Beispiel ein typisches CRM‑Setting. Ein klassisches RAG-System kann anhand einer Vektordatenbank z. B. die Frage beantworten: “Welche Supportanfragen ähneln diesem Ticket?”. Eine Frage, bei der jedoch verschiedene Informationen kontextualisiert zusammengeführt werden müssen, wie z. B. “Welche aktiven Kunden in Land X mit einem Jahresumsatz größer Y haben in den letzten 12 Monaten ein Supportticket gestellt?”, erfordert hingegen exakte Verknüpfungen und Filter, für die das RAG-System mit einer SQL-Wissensbasis kombiniert werden muss.
Notion, Obsidian & Confluence: Beseitigen Dokumenten-Chaos, aber bieten keine strukturierten Daten #
Auch Markdown- oder Block-basierte System wie Obsidian, Notion oder Confluence sind nicht grundsätzlich unstrukturiert. Präziser ist es, von semistrukturierten Systemen zu sprechen:
-
Notion-Datenbanken unterstützen typisierte Properties
-
Obisidan unterstützt YAML-basierte Properties
-
Confluence kann JSON-Properties speichern
Als Basis für Ihr KI Wissensmanagement im Unternehmen sind diese Systeme durch ihre auf Seiten beruhende Struktur nur bedingt geeignet. Oft werden sie auch noch als reine Seitensammlung genutzt, als Unternehmens-Wiki mit fehlenden Metadaten, unterschiedlichen Benennungslogiken, uneinheitlichen Properties und doppelten Einträgen. Wenn Sie KI Wissensmanagement auf so einem System aufbauen, verschwindet das übliche Wiki-Chaos nicht und ist auch nicht plötzlich strukturiert. Es wird lediglich semantisch durchsuchbar.
Das Problem des Kontextverlusts: Warum LLMs ohne klare Datenstruktur halluzinieren können #
Warum ist der fehlende Kontext nun ein Problem? Bei der Aufbereitung von Dokumenten oder internen Wissensdatenbanken kann Struktur an mehreren Stellen verloren gehen. Der zentrale Risikofaktor bei unstrukturierten oder semistrukturierten Datenbanken ist dabei die sogenannte Lossy Transformation: Ein Quelldokument oder eine Information wird in Chunks zerlegt, jeder Chunk wird separat vektorisiert und bei späteren Abfragen primär nach semantischer Ähnlichkeit für die Aufgabe herangezogen. Tabellen werden zu Text, Überschriften vom zugehörigen Abschnitt getrennt, Verbindungen zwischen zusammengehörenden Aussagen abgeschwächt und Links zwischen Objekten auf bloße Wörter reduziert. Wenn Ihr RAG-System anschließend nur einzelne Chunks findet, werden durch RAG an das LLM möglicherweise richtige Aussagen übergeben. Der Kontext, der ihre Gültigkeit begrenzt, geht indes verloren.
Ein Beispiel: Sie haben Kunden in verschiedenen Regionen mit verschiedenen Vertragsbedingungen. Ohne vollständigen Kontext kann ein Agent eine sachlich richtige Information abrufen, die aber für den betreffenden Standort oder den speziellen Kunden aufgrund von besonderen Faktoren nicht gilt.
Kontextverluste können an mehreren Stellen entstehen:
-
Ingest: Tabellen, Properties, Links oder Blockhierarchien werden zu Fließtext reduziert.
-
Chunking: Zusammengehörende Informationen landen in unterschiedlichen Chunks
-
Embedding: Bedeutungsähnlichkeit wird repräsenntiert, nicht automatisch logische oder kausale Zusammenhänge.
-
Retrieval: Eine reine Vektorsuche findet semantisch ähnliche Passagen, aber nicht zwingend alle relevanten Informationen.
-
Prompting: Metadaten und Beziehungen werden nicht mitgeliefert oder relevante Inhalte gehen in einem zu langen Kontext unter.
Warum größere Kontextfenster Kontextverlust nicht verhindern #
Um Halluzinationen oder Retrieval-Fehlern vorzubeugen, können Sie der KI in der Anfrage möglichst viel Kontext mitgeben. Das ist jedoch keine zuverlässige Lösung. Denn mit größeren Kontextfenstern steigt das sogenannte „Lost in the Middle“-Risiko. Forschungen zeigen, dass Informationen abhängig von ihrer Position in langen Kontextfenstern unterschiedlich zuverlässig genutzt werden können. Zudem wurden regelmäßig Leistungseinbußen allein durch längere Eingaben beobachtet.
Möglichst viele Informationen oder sogar ganze Dokumente in den Prompt zu laden, verschlechtert daher nicht nur Ihre Token-Effizienz. Es kann auch mehr Ablenkung erzeugen, wenn das LLM viele Informationen verarbeiten muss. Die Kosten steigen dabei üblicherweise mit der Zahl der verarbeiteten Tokens – nicht automatisch exponentiell –, denn API-Anbieter rechnen Eingabe- und Ausgabetokens nach Mengen ab. Knowledge Retrieval Optimization bedeutet, stattdessen möglichst wenig, aber vollständig relevanten Kontext bereitzustellen.
Welche Vorteile bieten strukturierte, relationale No-Code-Datenbanken für RAG? #
Eine strukturierte, relationale No-Code-Datenbank kann z. B. Kundeninformationen, Produkte, Assets oder Verträge als separate Tabellen führen. Verknüpfungen zwischen den Tabellen bilden die Beziehungen ab und eindeutige Datentypen und Pflichtfelder reduzieren Mehrdeutigkeit. So entstehen strukturierte, kontextualisierte Daten, die Ihr KI-Agent filtern, sortieren, verbinden und aggregieren kann, anstatt Verbindungen aus Textfragementen zu erraten.
Diese Datenarchitektur ermöglicht erst deterministische, also reproduzierbare KI-Antworten: Ihre Datenbankabfrage liefert bei identischem Datenstand und identischen Bedingungen dasselbe Ergebnis. Ihr LLM formuliert dieses Ergebnis in natürlicher Sprache.
Das bedeutet indes nicht, dass jede Antwort auch korrekt ist. Generative KI kann weiterhin Fehler machen, auch wenn Sie strukturierte Daten für KI Lösungen bereitstellen. Die kritischen Fakten stammen jedoch aus einer nachvollziehbaren Abfrage und nicht aus einer Ähnlichkeitsschätzung.
Dabei bedeutet eine No-Code-Lösung einen organisatorischen Vorteil für Ihr KI-basiertes Wissensmanagement: Fachabteilungen erstellen und pflegen Datenmodelle und Prozesse selbst, ohne jede Änderung an die IT-Abteilung zu delegieren.
Vektorisierung vs. Strukturierung: RAG-Systeme brauchen eine hybride Struktur #
Zunächst einmal ist die Frage Vekorisierung oder Strukturierung kein hartes Entweder-oder. Vektorisierung erschließt Bedeutungsähnlichkeiten; Strukturierung erlaubt Ihnen, Fakten und Beziehungen explizit abzufragen. Ein effektives, modernes RAG-System sollte beide Prinzipien kombinieren. Wenn Ihre interne Wissensdatenbank Informationen bereits strukturiert übergibt, erzielen RAG-Systeme deterministischere Ergebnisse, als wenn Daten und Informationen erst über die API gefiltert und strukturiert werden müssen. Daher sollten Sie strukturierte Kerninformationen in einer relationalen Datenbank speichern. Dokumente können Sie in geeigneten Content-Systemen ablegen, zum Beispiel kann das dieselbe relationale Datenbank sein, wenn sie dafür geeignet ist.
| Anforderung | Geeignete Zugriffsart | Beispiel |
|---|---|---|
| Semantische Ähnlichkeit | Vektorsuche | Ähnliche Supportfälle finden |
| Exakte Bedingung | SQL oder gefilterte API | Aktive Verträge eines Tarifs |
| Auflisten von Beziehungen | relationale Verknüpfung | Tickets dem richtigen Kunden zuordnen |
| Aggregation | Datenbankabfrage | Kritische Tickets je Kundensegment zählen |
| Freie Dokumentenabfrage | Hybride Suche | Passende Richtlinien oder Textpassagen finden |
RAG LLM Komponenten erhalten semantische Chunks, wenn Bedeutung entscheidend ist, und strukturierte Abfrageergebnisse, wenn es um Fakten und Berechnungen geht. Metadaten-Filtering reduziert den Suchraum, beispielsweise nach Sprache, Status, Dokumententyp oder Erstellungsdatum. Dadurch entstehen für RAG AI kürzere Kontexte und kontrollierbare Kosten.
MCP-Server und KI-Agenten: Die moderne Architektur für Enterprise Search #
Das Model Context Protocol standardisiert die Verbindung zwischen KI-Anwendungen und externen Ressourcen oder Werkzeugen. In der MCP-Architektur verwaltet ein Host einzelne Clients, die jeweils mit einem MCP-Server verbunden sind. Ihr KI-Agent mit RAG-Architektur erkennt über einen MCP-Server relevante Datenbanken und führt eine gezielte Abfrage durch. Das RAG-System lädt nur die benötigten Zeilen oder Dokumentenpassagen und führt, sofern Sie die Berechtigung dazu erteilen, auch Aktionen wie Aktualisierungen oder Änderungen durch.
MCP allein erzeugt jedoch nicht automatisch korrekte Antworten oder sichere Zugriffe. Ihr Server muss geeignete, klar begrenzte Systeme bereitstellen; der Host muss Zustimmungen, Richtlinien und Verbindungen kontrollieren. Nur so wird aus statischem KI Wissensmanagement eine dynamische Interaktion mit operativen Systemen zur kontrollierten Prozessunterstützung.
SeaTable als Single Source of Truth für KI-basiertes Wissensmanagement #
SeaTable ist eine moderne KI No-Code Datenbank mit starkem Fokus auf Flexibilität, Interoperabilität und höchstem Datenschutz. In einer oben beschriebenen RAG AI Architektur übernimmt SeaTable die strukturierte Wissensschicht. Tabellen, typisierte Spalten und Verknüpfungen bilden Entitäten und Beziehungen ab. Mit Link-Spalten modellieren Sie 1:n-, n:1- und n:m-Beziehungen. Damit können Sie strukturierte Daten für Ihr KI Wissensmanagement näher an den Fachprozessen pflegen als in einem reinen vektorbasierten Textindex. Granulare Zugriffs- und Bearbeitungsrechte in der Datenbank selbst unterstützen Compliance und Governance.
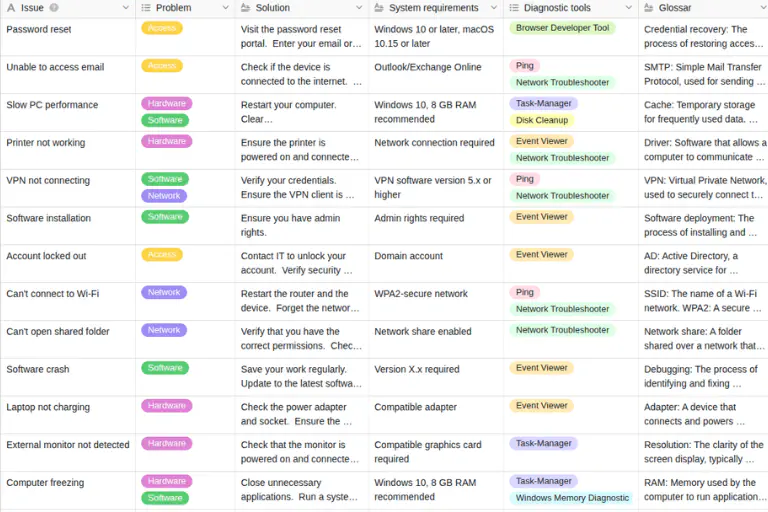
Der SeaTable MCP Server verbindet MCP-fähige KI-Assistenten mit einer freigegebenen Datenbank. Ihr RAG-System kann so aktuelle Datensätze gezielt abrufen, anstatt regelmäßig komplette Exporte neu zu vektorisieren. Der SeaTable MCP-Server wird wie die gesamte SeaTable-Infrastruktur auf Servern europäischer Unternehmen in Deutschland gehostet. Unternehmen mit besonders hohen Datenschutz- und Compliance-Anforderungen können SeaTable und den SeaTable MCP-Server auch on-premises hosten. So übernimmt SeaTable in Ihrer RAG AI Architektur die Rolle der Single Source of Truth für veränderliche, relationale Daten.
LLM Data Governance: Sicherheit und Zugriffskontrolle im Unternehmen verankern #
Eine produktive Agentenarchitektur muss dieselben Grundfragen beantworten wie andere Enterprise-Systeme auch: Wer darf welche Daten für welchen Zweck lesen, verändern oder exportieren? LLM Data Governance beginnt daher bei Datenklassifikation und Identitäten, und nicht erst beim Prompt.
Für jedes RAG-System sollten mindestens folgende Kontrollen definiert werden:
-
eine führende Quelle und verantwortliche Data Owner je Entität,
-
rollen- oder attributbasierte Zugriffsregeln,
-
getrennte Lese- und Schreibrechte nach dem Least-Privilege-Prinzip,
-
Filterung vor dem Retrieval statt nach der Modellausgabe,
-
Protokolle für Abfragen, Quellen, Tool-Aufrufe und Änderungen,
-
Versionierung, Löschkonzepte und definierte Aufbewahrungsfristen,
-
Tests gegen Prompt Injection, Datenabfluss und unzulässige Aktionen,
-
Human-in-the-Loop-Freigaben für irreversible oder sicherheitskritische Schritte.
Ein RAG-System darf nicht durch bloßes Erraten eines Identifikators auf fremde Daten zugreifen. Daher müssen Berechtigungen immer sowohl auf Ebene der Datenbank als auch im RAG-System durchgesetzt werden. Durch gezieltes Retrieval stärken Sie zudem die Kostenkontrolle. Metadaten-Filtering und strukturierte Abfragen reduzieren irrelevante Eingabetokens, und Caching kann wiederkehrenden Kontext günstiger machen.
Fazit: Strukturierte Daten als Fundament für Wissensmanagement mit KI #
Zuverlässiges KI-Wissensmanagement beginnt bei einer strukturierten No-Code-Datenbank. Sie bildet als Single Source of Truth das Fundament, auf dem ein RAG-System exakte Antworten liefern kann. Tabellen, definierte Felder und Verknüpfungen machen Zusammenhänge explizit. KI-Agenten müssen sie nicht mehr aus Textfragmenten rekonstruieren.
Über einen MCP-Server greifen Agenten kontrolliert auf diese Daten zu, filtern per Metadaten und rufen nur relevante Datensätze ab. Das erhöht die Präzision, senkt den Token-Verbrauch und stärkt die LLM Data Governance, weil Zugriffsrechte am Datenmodell ansetzen.
Halluzinationen verhindert das nicht vollständig, denn das LLM formuliert weiterhin nach Wahrscheinlichkeit. Doch die Fakten sind reproduzierbar und überprüfbar. Wer KI-Agenten im Unternehmen einsetzt, sollte deshalb zuerst die strukturierte Datenbasis schaffen.
FAQ – Wissensmanagement mit KI #
Warum reicht eine Vektordatenbank allein für ein RAG-System oft nicht aus?
Wie verbessert ein MCP-Server die Anbindung von No-Code-Datenbanken an KI-Agenten?
Welche Rolle spielt eine No-Code-Datenbank im KI Wissensmanagement in Unternehmen?
Senkt ein RAG-System meine LLM-Kosten?
Was ist der Vorteil von deterministischen KI-Antworten in Unternehmen?
TAGS: Digitale Transformation Datenmanagement & Visualisierung IT Prozesse