Почему стоит размещать собственный ИИ #
Писать тексты, резюмировать электронные письма, создавать изображения: генеративный ИИ давно вошёл в повседневную работу. Всё больше компаний используют искусственный интеллект продуктивно, автоматизируют процессы и открывают новые резервы эффективности. При этом ИИ-инструменты всё чаще превращаются из экспериментального набора в критически важную для бизнеса технологию.
Поэтому во многих местах растут как сомнения, так и требования в отношении защиты данных, суверенитета данных, контроля расходов и ИТ-безопасности. Тот, кто передаёт конфиденциальные данные компании, внутренние документы или исходный код внешним Cloud AI Services, должен ясно понимать, где эти данные окажутся, насколько они защищены и используются ли они при обучении моделей.
Если же вы размещаете ИИ самостоятельно, то переносите обработку данных в собственную инфраструктуру . Локальная LLM (Large Language Model) может работать, например, на ИИ-сервере в центре обработки данных вашей компании. Так вы создаёте техническую основу для цифрового суверенитета .
Собственный хостинг ИИ: важнейшие преимущества с первого взгляда #
- Высочайший уровень защиты данных: конфиденциальные данные находятся внутри вашей собственной серверной инфраструктуры и не передаются внешним ИИ-сервисам.
- Цифровой суверенитет: с моделью с открытым исходным кодом вы можете обучать собственный ИИ и действовать независимо от крупных поставщиков ИИ.
- Полный контроль расходов: при локальном ИИ не возникает платы за токены в зависимости от использования, и вас не затрагивает рост цен на внешний облачный ИИ.
- Больше гибкости: вы сами решаете, какую модель ИИ использовать, на каких данных её обучать и когда устанавливать новые версии.
- Бесшовная интеграция: через API-интерфейсы локальный ИИ можно объединить с базами данных, приложениями и автоматизациями в единую комплексную систему.
Локальный искусственный интеллект против облачного ИИ #
Решение о том, использовать облачный ИИ или размещать ИИ самостоятельно, даётся непросто. У обоих подходов есть свои плюсы и минусы. Предпочтение self-hosting или Cloud AI зависит прежде всего от того, какой вес вы придаёте тем или иным критериям. Поэтому оцените, насколько высоки в действительности ваши требования к цифровому суверенитету, защите данных, комплаенсу, масштабируемости, размеру модели и совокупной стоимости.
-
Cloud AI Services часто выигрывают за счёт простого масштабирования по мере использования и быстрого запуска без установки оборудования. Это значит, что вам не нужно закупать и обслуживать GPU-инфраструктуру — вы пользуетесь ИИ-серверами провайдера. Для отдельных задач, тестовых этапов или сильно колеблющейся, плохо прогнозируемой нагрузки облачный ИИ может быть особенно привлекательным.
-
В противоположность этому локальный искусственный интеллект на вашем собственном ИИ-сервере даёт полный контроль над обработкой данных. Вы сами решаете, какие модели использовать, с какими системами они интегрированы и какие данные обрабатывают. При стабильно высокой нагрузке на ИИ и высокой ценности (конфиденциальных) данных self-hosting становится интересным и с экономической точки зрения.
| Критерий | Локальный ИИ | Облачный ИИ |
|---|---|---|
| Оборудование | в собственности | арендуется по мере необходимости |
| Контроль над данными | очень высокий | низкий, зависит от провайдера |
| Масштабируемость | негибкая, зависит от оборудования | очень гибкая и простая |
| Затраты на обслуживание | высокие | низкие |
| Расходы | высокие затраты на приобретение и эксплуатацию | текущие лицензионные расходы, чаще всего по факту использования |
| Работа офлайн | возможна | невозможна |
Оборудование и инфраструктура: что нужно собственному ИИ-серверу? #
Если вы хотите размещать ИИ самостоятельно, учитывать следует не только возможности моделей. Решающим является сочетание оборудования, размера модели и конкретных бизнес-процессов. Поэтому центральный вопрос звучит так: сколько вычислительной мощности вам нужно для ваших ИИ-процессов? Собственному ИИ-серверу прежде всего требуются GPU, VRAM, SSD-накопители и охлаждение. При нескольких параллельных пользователях добавляются ещё эффективная загрузка GPU и пропускная способность сети.
GPU и VRAM #
Графические процессоры (Graphics Processing Units, GPU) сегодня образуют сердце ИИ-серверов. Для LLM особенно важен доступный объём VRAM (Video Random Access Memory) графического процессора. Под этим понимают локальную оперативную память видеокарты, которая служит быстрым промежуточным хранилищем при создании текстов, графики и изображений.
Не всегда приходится тратить на видеокарты крупные суммы. Небольшие модели ИИ отчасти можно запускать уже на производительном потребительском оборудовании с объёмом памяти до 12 ГБ, тогда как более крупные модели требуют заметно больше памяти GPU (обычно свыше 24 ГБ).
Инженерная инфраструктура #
Собственный ИИ-сервер может выделять много тепла, а также иметь огромное энергопотребление и пропускную способность. Поэтому для самостоятельного размещения ИИ вам, помимо уже упомянутых компонентов, понадобятся специальные системы охлаждения, кабельная проводка, сети, источники бесперебойного питания и, конечно, серверные помещения, в которых будет стоять ваш собственный ИИ-сервер.
Подходящие модели для самостоятельного хостинга ИИ #
Какие модели ИИ лучше всего подходят для локального использования? Это зависит главным образом от желаемого размера модели, сценария применения и доступного оборудования.
Размеры моделей ИИ от 7B до 70B #
7B и 70B обозначают количество параметров модели ИИ в миллиардах (по-английски «billion»), причём 7 миллиардов параметров соответствуют небольшой модели, а 70 миллиардов параметров — крупной. В зависимости от сценария применения при самостоятельном хостинге ИИ лучше подойдёт либо маленькая, быстрая и недорогая модель 7B, либо большая, ресурсоёмкая и затратная модель 70B. В качестве грубого ориентира может служить следующий обзор:
- Модели 7B идеальны для несложных задач вроде чатов и простых автоматизаций. Они понимают обычные тексты, пишут резюме или отвечают на простые вопросы. Однако в сложных логических задачах или при глубоких специальных знаниях они ошибаются. Зато им нужно мало электроэнергии и вычислительной мощности, и они могут работать уже на обычном игровом ПК.
- Модели 70B способны решать комплексные задачи, брать на себя более требовательные корпоративные задания и обсуждать сложные темы на уровне эксперта. Но им требуется больше времени на вычисления и ответ, а также высокий объём VRAM. Из-за этого они потребляют заметно больше электроэнергии в эксплуатации и требуют дорогих профессиональных видеокарт, которые обычно встречаются в центрах обработки данных.
| Аспект | Модели 7B | Модели 70B |
|---|---|---|
| Размер модели | небольшой | большой |
| Скорость ответа | очень высокая | ощутимо ниже |
| Логика | простая | сложная |
| Требования к оборудованию | относительно низкие | очень высокие |
| Расходы | невысокие | высокие |
| Типичные области применения | напр. простая автоматизация, чат-боты | напр. сложная аналитика и требовательные задачи |
Квантизация #
Кроме того, обращать внимание следует не только на размер модели, но и на квантизацию. Ведь квантизованные варианты моделей требуют существенно меньше VRAM, чем модели с полной точностью. Под квантизацией понимают снижение точности вычислений в моделях ИИ, например с 32-битных чисел с плавающей запятой до 8-битных целых чисел. При этом принимается компромисс между скоростью и точностью вычислений.
Квантизация снижает вычислительные затраты и может сделать крупные модели практичными для локальных систем ИИ, повышая скорость ответа при неизменной вычислительной мощности оборудования. Разумная стратегия при самостоятельном хостинге ИИ — начать сначала с квантизованной модели. Так вы сможете проверить, какой скорости ответа и какого качества требует ваш конкретный сценарий, прежде чем инвестировать в более производительную GPU-инфраструктуру.
Модели с открытым исходным кодом для самостоятельного хостинга ИИ #
Если вы хотите размещать ИИ самостоятельно, особенно хорошо подходят некоммерческие модели с открытым исходным кодом разных размеров и возможностей. Очень популярная модель — Llama 3.3, которая сегодня считается стандартом для собственных ИИ-серверов с мощным оборудованием. Здесь вы видите сравнение Llama 3.3 американской корпорации Meta с европейской моделью от Mistral и китайской альтернативой от Alibaba. Все модели имеют открытый исходный код и используют Q4-квантизацию, благодаря чему потребность в памяти сокращается примерно вчетверо по сравнению с полной точностью.
| Название | Поставщик | Размер | Основная область применения | Требуемый VRAM |
|---|---|---|---|---|
| Llama 3.3 | Meta | 70B | универсал со сложной логикой | 42–45 ГБ |
| Qwen 2.5 Coder | Alibaba | 32B | программирование и анализ данных | 20–24 ГБ |
| Mistral Large 2 | Mistral | 123B | бизнес-приложения и агенты | 75–80 ГБ |
Локальная установка и эксплуатация ИИ: Ollama, vLLM и другие #
Если вы хотите установить ИИ локально, сегодня вам больше не нужно разрабатывать сложную программную архитектуру. Некоторые инструменты способны существенно упростить старт.
Ollama #
Ollama — это программное обеспечение с открытым исходным кодом, которое позволяет вам эксплуатировать ИИ локально. С помощью Ollama вы можете загружать свободно доступные языковые модели прямо на свой компьютер и делать их доступными для множества приложений через стандартизированный интерфейс. Недостаток в том, что у Ollama нет графического пользовательского интерфейса для Linux, поэтому требуются технические знания.
vLLM #
Как и Ollama, vLLM представляет собой инференс-движок с открытым исходным кодом для больших языковых моделей (LLM). Однако его настройка и сценарии применения в сравнении более требовательны. vLLM рассчитан на высокую пропускную способность и несколько GPU и особенно подходит для собственных ИИ-серверов с большим числом параллельных запросов. Он отличается тем, что делает работу моделей ИИ на собственном оборудовании быстрее, эффективнее и масштабируемее.
LM Studio #
Благодаря простому в обращении десктопному приложению с графическим интерфейсом LM Studio выигрывает как доступная альтернатива Ollama и vLLM. При этом LM Studio интегрирует платформу Hugging Face, которая открывает доступ к различным моделям ИИ. Как только вы загрузите и установите подходящую модель, вы сможете сразу же начать общение с чат-ботом. Зато LM Studio и более требователен к ресурсам, а его исходный код закрыт.
Open Web UI #
Ещё один интересный компонент на случай, если вы хотите размещать ИИ самостоятельно, — Open Web UI. С помощью этой self-hosted-платформы ИИ вы можете создать удобный веб-интерфейс для моделей ИИ, которые вы эксплуатируете локально, например через Ollama или vLLM. Так изначально малодоступная локальная LLM превращается в приложение, которым могут пользоваться и люди без технических специальных знаний.
Пример архитектуры для самостоятельного хостинга ИИ #
Типичная архитектура могла бы выглядеть, например, так:
Пользователь → Open Web UI → Ollama или vLLM → локальная LLM
Таким образом вы можете установить ИИ локально и подключать приложения через API. При локальной эксплуатации ИИ вам следует с самого начала продумать также мониторинг, аутентификацию, права доступа, резервные копии и обновления. Запустить LLM на собственном ИИ-сервере — технически лишь первый шаг на пути к безопасной продуктивной системе.
No-Code AI и рабочие процессы: умная интеграция ИИ #
Наибольшая польза нередко возникает не от самого ИИ, а от его встраивания в бизнес-процессы . Локальный искусственный интеллект может, например, анализировать новые записи из внутренней базы данных, классифицировать тексты или резюмировать входящие документы. Через API-интерфейс результат можно затем передать, например, в CRM-систему или запустить автоматизацию.
Благодаря No-Code AI — например, с помощью No Code AI Workflow Builder — такие процессы можно в значительной мере смоделировать без классического программирования. Это снижает затраты на разработку и делает функции ИИ доступными для citizen developer в компании. Если вы самостоятельно размещаете и No Code AI Workflow Builder, и сам ИИ, обработка данных происходит исключительно внутри вашей собственной инфраструктуры.
ИИ-автоматизации SeaTable #
В SeaTable выбор за вами: воспользуйтесь масштабируемостью и удобством облака или установите SeaTable on-premises на собственной инфраструктуре. Как No-Code-платформа с ИИ SeaTable открывает перед вами интересные возможности, например сочетание No Code , реляционных баз данных и ИИ-автоматизаций : используйте мощные функции, такие как Summarize, OCR, Extract, Classify и Custom Prompts.
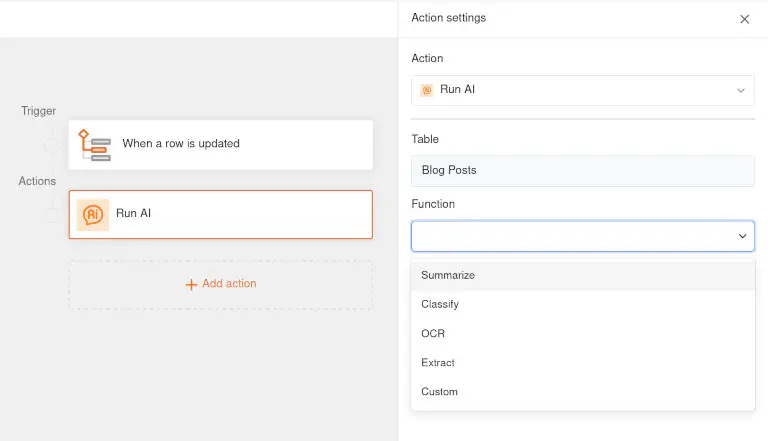
SeaTable Cloud использует в качестве модели ИИ Gemma3 от Google с 12 миллиардами параметров. Для облачных пользователей ИИ-автоматизации выполняются на нашем собственном ИИ-сервере в Германии. Ваши данные ни в какой момент не покидают эту инфраструктуру и не передаются ни Google, ни другим американским поставщикам.
Ради полного контроля вы можете самостоятельно разместить не только SeaTable Server , но и свой ИИ. Так вы сможете автоматизировать рабочие процессы, не передавая конфиденциальную информацию внешнему облачному ИИ. Компонент SeaTable AI основан на LiteLLM и благодаря этому поддерживает подключение множества моделей — включая все LLM-сервисы с OpenAI-совместимым API. В нашем руководстве администратора вы найдёте инструкцию по развёртыванию SeaTable AI и примеры конфигураций для многочисленных популярных LLM.
Подключение ИИ-агентов к SeaTable #
Хотите вести диалог со своей базой данных в SeaTable в режиме реального времени или изменять её с помощью индивидуальных промптов на естественном языке? Тогда ИИ-агент — именно то решение, которое вам нужно! За этим подходом стоит MCP-сервер SeaTable . MCP (Model Context Protocol) — это открытый стандарт, который позволяет моделям ИИ активно взаимодействовать с источниками данных. Так чат-бот может напрямую обращаться к вашей базе данных в SeaTable и отвечать на вопросы о ней — без обходных путей и потери информации.
Лучше всего это работает с производительными моделями ИИ (напр. Claude Desktop от Anthropic), которые способны отвечать на сложные вопросы и работать с вашими данными в несколько этапов. По соображениям защиты данных важно понимать, что вы предоставляете ИИ-агенту доступ к данным в вашей базе SeaTable. Правами ИИ-агента вы управляете через API-токен, который создаёте в SeaTable. Если вы размещаете ИИ самостоятельно, то можете установить на собственной инфраструктуре как SeaTable, так и MCP-сервер и связать их с локальным ИИ (например, через Ollama или LM Studio). Тогда ваши данные ни в какой момент не покинут вашу систему. Больше информации об этом вы найдёте здесь .
Итог: самостоятельный хостинг ИИ обеспечивает цифровую независимость #
Размещая собственный ИИ, вы сами решаете, какую модель использовать, эксплуатируете собственный ИИ-сервер и сохраняете полный контроль над своими данными. Это особенно интересно компаниям с высокими требованиями к защите данных и государственному сектору . Однако тот, кто хочет размещать ИИ самостоятельно, должен реалистично планировать инфраструктуру: GPU и VRAM во многом определяют возможный размер модели, а квантизация способна оптимизировать скорость.
С правильной архитектурой и открытым программным обеспечением вроде Ollama или vLLM ИИ можно эксплуатировать локально и интегрировать через API в существующие бизнес-процессы. Инструменты No-Code AI, такие как SeaTable, в свою очередь позволяют эффективно автоматизировать ваши рабочие процессы , а также анализировать и редактировать ваши No-Code-базы данных с помощью ИИ-агентов, не передавая конфиденциальные деловые данные внешнему облачному ИИ.
FAQ: самостоятельный хостинг ИИ #
В чём главное преимущество размещения собственного ИИ?
Какое оборудование мне нужно для собственного ИИ-сервера?
Чем производительность локального ИИ отличается от коммерческого облачного ИИ?
Можно ли связать локальный ИИ с No-Code-инструментами и автоматизациями?
Какие модели с открытым исходным кодом подходят для локальной эксплуатации ИИ?
TAGS: Цифровая Трансформация ИТ-Безопасность И Конфиденциальность Данных Интеграции И Автоматизация