Pourquoi héberger votre propre IA #
Rédiger des textes, résumer des e-mails, créer des images : l’IA générative fait depuis longtemps partie du quotidien professionnel. De plus en plus d’entreprises utilisent l’intelligence artificielle de manière productive, automatisent des processus et exploitent de nouveaux gisements d’efficacité. Les outils d’IA passent ainsi progressivement du statut de boîte à expériences à celui de technologie critique pour l’activité.
C’est pourquoi, en de nombreux endroits, les réserves grandissent autant que les exigences en matière de protection des données, de souveraineté des données, de maîtrise des coûts et de sécurité informatique. Quiconque transmet des données d’entreprise sensibles, des documents internes ou du code source à des Cloud AI Services externes devrait savoir clairement où ces données atterrissent, dans quelle mesure elles sont protégées ou si elles servent à l’entraînement des modèles.
Si vous hébergez une IA vous-même, vous déplacez en revanche le traitement des données dans votre propre infrastructure . Un LLM local (Large Language Model) peut par exemple tourner sur un serveur IA situé dans le centre de données de votre entreprise. Vous créez ainsi le socle technique de la souveraineté numérique .
Héberger son IA soi-même : les principaux avantages en un coup d’œil #
- Une protection des données de haut niveau : les données sensibles restent au sein de votre propre infrastructure de serveurs et ne sont pas transmises à des services d’IA externes.
- Souveraineté numérique : avec un modèle open source, vous pouvez entraîner votre propre IA et agir indépendamment des grands fournisseurs d’IA.
- Maîtrise totale des coûts : avec une IA locale, aucun coût de tokens lié à l’usage n’est facturé et vous êtes à l’abri des hausses de prix des cloud IA externes.
- Plus de flexibilité : vous décidez vous-même quel modèle d’IA utiliser, avec quelles données l’entraîner et quand installer de nouvelles versions.
- Intégration sans rupture : via des interfaces API, l’IA locale peut être reliée à des bases de données, des applications et des automatisations pour former un système complet.
Intelligence artificielle locale ou IA dans le cloud #
Choisir entre un cloud IA et une IA hébergée par vos soins n’est pas simple. Les deux approches ont leurs avantages et leurs inconvénients. La préférence pour le self-hosting ou pour le Cloud AI dépend avant tout du poids que vous accordez à certains critères. Évaluez donc le niveau réel de vos exigences en matière de souveraineté numérique, de protection des données, de conformité, d’évolutivité, de taille de modèle et de coût global.
-
Les Cloud AI Services séduisent souvent par une montée en charge simple, facturée à l’usage, et par une mise en place rapide sans installation matérielle. Autrement dit, vous n’avez pas à acquérir ni à entretenir une infrastructure GPU : vous utilisez les serveurs IA du fournisseur. Pour des tâches ponctuelles, des phases de test ou un usage très fluctuant et difficilement prévisible, le cloud IA peut être particulièrement attrayant.
-
À l’inverse, l’intelligence artificielle locale sur votre propre serveur IA offre le contrôle total du traitement des données. Vous décidez vous-même quels modèles utiliser, à quels systèmes ils sont intégrés et quelles données ils traitent. Avec une utilisation de l’IA constamment élevée et des données (confidentielles) de grande valeur, le self-hosting devient aussi intéressant sur le plan économique.
| Critère | IA locale | IA dans le cloud |
|---|---|---|
| Matériel | en propriété | loué selon les besoins |
| Contrôle des données | très élevé | faible, dépend du fournisseur |
| Évolutivité | peu flexible, dépend du matériel | très flexible et simple |
| Effort de maintenance | élevé | faible |
| Coûts | coûts d’acquisition et d’exploitation élevés | coûts de licence récurrents, le plus souvent liés à l’usage |
| Fonctionnement hors ligne | possible | impossible |
Matériel et infrastructure : que faut-il pour un serveur IA à soi ? #
Si vous souhaitez héberger une IA vous-même, vous ne devriez pas vous en tenir aux seules capacités des modèles. Ce qui est déterminant, c’est l’interaction entre le matériel, la taille du modèle et vos processus métier concrets. La question centrale est donc la suivante : de quelle puissance de calcul avez-vous besoin pour vos processus d’IA ? Votre propre serveur IA a besoin avant tout d’un GPU, de VRAM, de stockage SSD et de refroidissement. En cas d’utilisateurs multiples en parallèle s’ajoutent une utilisation efficace du GPU et une bande passante réseau suffisante.
GPU et VRAM #
Les processeurs graphiques (Graphics Processing Units, GPU) constituent aujourd’hui le cœur des serveurs IA. Pour les LLM, c’est surtout la VRAM (Video Random Access Memory) disponible du GPU qui compte. On désigne ainsi la mémoire vive locale d’une carte graphique, qui sert de mémoire tampon rapide pour créer des textes, des graphiques et des images.
Vous n’avez pas toujours besoin de dépenser des fortunes en cartes graphiques. Les petits modèles d’IA peuvent en partie tourner sur du matériel grand public performant doté de 12 Go au maximum, tandis que les modèles plus grands exigent nettement plus de mémoire GPU (le plus souvent au-delà de 24 Go).
Infrastructure physique #
Un serveur IA à soi peut dégager beaucoup de chaleur résiduelle et présenter une consommation électrique et un débit considérables. Pour pouvoir héberger votre IA vous-même, vous avez donc besoin, outre les composants déjà cités, de systèmes de refroidissement, de câblage, de réseaux, d’une alimentation électrique sans interruption et, bien sûr, de salles de serveurs spécifiques pour accueillir votre propre serveur IA.
Les modèles adaptés pour héberger son IA soi-même #
Quels modèles d’IA conviennent le mieux pour utiliser une IA en local ? Cela dépend principalement de la taille de modèle souhaitée, du cas d’usage et du matériel disponible.
Tailles de modèles d’IA, de 7B à 70B #
7B et 70B désignent le nombre de paramètres d’un modèle d’IA en milliards (« billion » en anglais), 7 milliards de paramètres correspondant à un petit modèle et 70 milliards de paramètres à un grand modèle. Selon le cas d’usage, un petit modèle 7B rapide et économique ou un grand modèle 70B gourmand en calcul et coûteux peut être plus adapté lorsque vous souhaitez héberger votre IA vous-même. L’aperçu suivant sert de repère approximatif :
- Les modèles 7B sont idéaux pour des tâches simples comme les chats et les automatisations élémentaires. Ils savent comprendre des textes ordinaires, rédiger des résumés ou répondre à des questions simples. En revanche, ils se trompent sur des énigmes logiques compliquées ou sur des connaissances spécialisées pointues. En contrepartie, ils consomment peu d’électricité et de puissance de calcul et peuvent déjà tourner sur un PC gaming du commerce.
- Les modèles 70B savent résoudre des problèmes complexes, prendre en charge des tâches d’entreprise plus exigeantes et discuter de sujets difficiles comme un expert. Mais ils mettent plus de temps à calculer et à répondre et présentent des besoins élevés en VRAM. Ils coûtent donc nettement plus cher en électricité à l’usage et nécessitent des cartes graphiques professionnelles onéreuses, que l’on trouve habituellement dans les centres de données.
| Aspect | Modèles 7B | Modèles 70B |
|---|---|---|
| Taille du modèle | petite | grande |
| Vitesse de réponse | très rapide | sensiblement plus lente |
| Logique | simple | complexe |
| Exigences matérielles | relativement faibles | très élevées |
| Coûts | avantageux | élevés |
| Domaines d’usage typiques | p. ex. automatisation simple, chatbots | p. ex. analyses complexes et tâches exigeantes |
Quantification #
Par ailleurs, vous ne devriez pas vous intéresser uniquement à la taille du modèle, mais aussi à la quantification. En effet, les variantes quantifiées des modèles ont besoin de nettement moins de VRAM que les modèles en pleine précision. La quantification consiste à réduire la précision de calcul des modèles d’IA, par exemple en passant de nombres à virgule flottante 32 bits à des nombres entiers 8 bits. On accepte alors un compromis entre la vitesse et la précision des calculs.
La quantification réduit la charge de calcul et peut rendre de grands modèles praticables pour des systèmes d’IA locaux, en augmentant la vitesse de réponse à puissance de calcul matérielle constante. Une stratégie judicieuse lorsque l’on héberge son IA soi-même consiste à démarrer d’abord avec un modèle quantifié. Vous pouvez ainsi tester quelle vitesse de réponse et quelle qualité votre cas d’usage concret exige, avant d’investir dans une infrastructure GPU plus performante.
Les modèles open source avec lesquels héberger son IA soi-même #
Si vous souhaitez héberger votre IA vous-même, les modèles open source non commerciaux, de tailles et de capacités variées, sont particulièrement indiqués. Un modèle très apprécié est Llama 3.3, considéré aujourd’hui comme le standard pour un serveur IA à soi doté d’un matériel performant. Voici une comparaison de Llama 3.3, du groupe américain Meta, avec un modèle européen de Mistral et une alternative chinoise d’Alibaba. Tous ces modèles sont open source et utilisent une quantification Q4, ce qui divise les besoins en mémoire par environ quatre par rapport à la pleine précision.
| Nom | Fournisseur | Taille | Domaine d’usage principal | VRAM nécessaire |
|---|---|---|---|---|
| Llama 3.3 | Meta | 70B | polyvalent, logique complexe | 42 à 45 Go |
| Qwen 2.5 Coder | Alibaba | 32B | programmation et analyse de données | 20 à 24 Go |
| Mistral Large 2 | Mistral | 123B | applications métier et agents | 75 à 80 Go |
Installer et exploiter une IA en local : Ollama, vLLM & Cie #
Si vous souhaitez installer une IA en local, vous n’avez plus besoin aujourd’hui de développer une architecture logicielle complexe. Quelques outils peuvent considérablement faciliter vos débuts.
Ollama #
Ollama est un logiciel open source qui vous permet d’exploiter une IA en local. Grâce à Ollama, vous pouvez télécharger des modèles de langage librement disponibles directement sur votre machine et les mettre à disposition d’une multitude d’applications via une interface standardisée. Un inconvénient : Ollama ne dispose pas d’interface graphique pour Linux, ce qui suppose des connaissances techniques préalables.
vLLM #
Tout comme Ollama, vLLM est un moteur d’inférence open source pour grands modèles de langage (LLM). Sa mise en place et ses cas d’usage sont toutefois plus exigeants en comparaison. vLLM est conçu pour un débit élevé et plusieurs GPU et convient tout particulièrement à un serveur IA à soi traitant de nombreuses requêtes en parallèle. Il se distingue en rendant l’exploitation de modèles d’IA sur du matériel personnel plus rapide, plus efficace et plus évolutive.
LM Studio #
Grâce à une application de bureau à interface graphique simple d’utilisation, LM Studio s’impose comme une alternative accessible à Ollama et vLLM. LM Studio intègre en outre la plateforme Hugging Face, qui donne accès à différents modèles d’IA. Dès que vous avez téléchargé et installé un modèle adapté, vous pouvez immédiatement interagir avec le chatbot. En contrepartie, LM Studio est aussi plus gourmand en ressources et n’est pas open source.
Open Web UI #
Autre composant intéressant si vous souhaitez héberger votre IA vous-même : Open Web UI. Avec cette plateforme d’IA auto-hébergée, vous pouvez créer une interface web conviviale pour des modèles d’IA que vous exploitez en local, par exemple avec Ollama ou vLLM. Un LLM local d’abord peu accessible devient ainsi une application utilisable également par des personnes sans expertise technique.
Exemple d’architecture pour héberger son IA soi-même #
Une architecture typique pourrait par exemple se présenter ainsi :
Utilisateur → Open Web UI → Ollama ou vLLM → LLM local
Vous pouvez ainsi installer une IA en local et y raccorder des applications via des API. Si vous exploitez une IA en local, vous devriez en outre penser dès le départ à la supervision, à l’authentification, aux autorisations, aux sauvegardes et aux mises à jour. Démarrer un LLM sur votre propre serveur IA n’est techniquement que la première étape vers un système de production sécurisé.
No-Code AI et workflows : intégrer l’IA intelligemment #
La plus forte valeur ajoutée ne vient souvent pas de l’IA elle-même, mais de son intégration dans vos processus métier . Une intelligence artificielle locale peut par exemple analyser de nouveaux enregistrements issus d’une base de données interne, classer des textes ou résumer des documents entrants. Via une interface API, le résultat peut ensuite être transmis par exemple à un système CRM ou déclencher une automatisation.
Grâce au No-Code AI – par exemple avec un No Code AI Workflow Builder – vous pouvez modéliser de tels enchaînements en grande partie sans programmation classique. Cela réduit l’effort de développement et rend les fonctions d’IA accessibles aux citizen developers de l’entreprise. Si vous hébergez vous-même à la fois le No Code AI Workflow Builder et l’IA, le traitement des données a lieu exclusivement au sein de votre propre infrastructure.
Les automatisations IA de SeaTable #
Chez SeaTable, vous avez le choix : profitez de l’évolutivité et du confort du cloud ou installez SeaTable on-premises sur votre propre infrastructure. En tant que plateforme No-Code dotée d’IA , SeaTable vous ouvre des possibilités intéressantes, comme la combinaison du No Code , des bases de données relationnelles et des automatisations IA : utilisez des fonctions puissantes telles que Summarize, OCR, Extract, Classify et Custom Prompts.
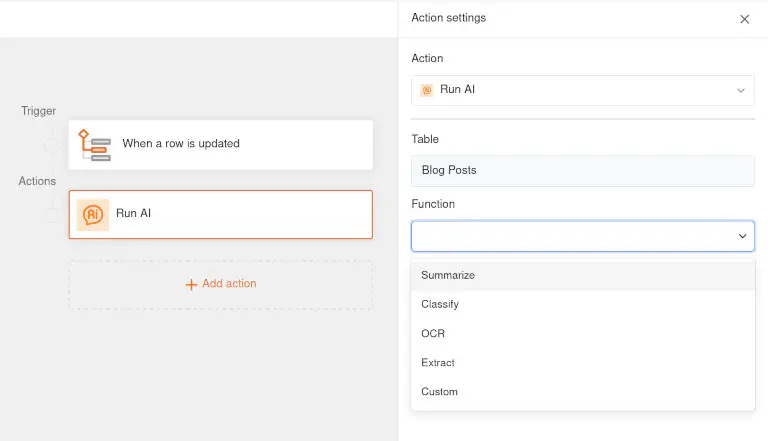
SeaTable Cloud utilise comme modèle d’IA un Gemma3 de Google doté de 12 milliards de paramètres. Pour les utilisateurs du cloud, les automatisations IA passent par notre propre serveur IA en Allemagne. Vos données ne quittent à aucun moment cette infrastructure et ne sont transmises ni à Google ni à d’autres fournisseurs américains.
Pour un contrôle total, vous pouvez héberger vous-même non seulement SeaTable Server , mais aussi votre IA. Vous pouvez ainsi automatiser vos workflows sans avoir à transmettre d’informations sensibles à un cloud IA externe. Le composant SeaTable AI repose sur LiteLLM et prend donc en charge le raccordement d’une multitude de modèles – dont tous les services LLM disposant d’une API compatible OpenAI. Dans notre manuel d’administration, vous trouverez le guide de déploiement de SeaTable AI ainsi que des exemples de configuration pour de nombreux LLM populaires.
Connecter des agents IA à SeaTable #
Vous souhaitez dialoguer en temps réel avec votre base de données dans SeaTable ou la modifier à l’aide de prompts personnalisés en langage naturel ? Un agent IA est alors exactement la bonne solution ! Derrière cette approche se cache le serveur MCP de SeaTable . MCP (Model Context Protocol) désigne un standard ouvert qui permet aux modèles d’IA d’interagir activement avec des sources de données. Le chatbot peut ainsi accéder directement à votre base de données dans SeaTable et répondre à des questions à son sujet – sans détour ni perte d’information.
Cela fonctionne au mieux avec des modèles d’IA performants (p. ex. Claude Desktop d’Anthropic), capables de répondre à des questions complexes et de travailler avec vos données en plusieurs étapes. Pour des raisons de protection des données, il est important de comprendre que vous accordez à l’agent IA l’accès aux données de votre base SeaTable. Vous pilotez les autorisations de l’agent IA via le jeton d’API que vous générez dans SeaTable. Si vous hébergez une IA vous-même, vous pouvez installer SeaTable et le serveur MCP sur votre propre infrastructure et les relier à l’IA locale (par exemple via Ollama ou LM Studio). Vos données ne quittent ainsi à aucun moment votre système. Vous trouverez davantage d’informations à ce sujet ici .
Conclusion : héberger son IA soi-même procure une indépendance numérique #
Lorsque vous hébergez votre propre IA, vous décidez vous-même du modèle d’IA, exploitez votre propre serveur IA et conservez le contrôle total de vos données. C’est particulièrement intéressant pour les entreprises aux exigences élevées en matière de protection des données ainsi que pour le secteur public . Qui souhaite héberger son IA soi-même doit toutefois planifier son infrastructure de façon réaliste : le GPU et la VRAM déterminent pour l’essentiel la taille de modèle possible, la quantification pouvant optimiser la vitesse.
Avec la bonne architecture et des logiciels open source comme Ollama ou vLLM, il est possible d’exploiter une IA en local et de l’intégrer via des API aux processus existants de l’entreprise. Les outils No-Code AI tels que SeaTable vous permettent quant à eux d’automatiser efficacement vos workflows et d’analyser et modifier vos bases de données No-Code avec des agents IA, sans devoir transmettre de données commerciales sensibles à un cloud IA externe.
FAQ : héberger son IA soi-même #
Quel est le principal avantage d’héberger sa propre IA ?
De quel matériel ai-je besoin pour un serveur IA à moi ?
En quoi les performances d’une IA locale diffèrent-elles de celles d’un cloud IA commercial ?
Puis-je relier une IA locale à des outils No-Code et à des automatisations ?
Quels modèles open source conviennent pour exploiter une IA en local ?
TAGS: Transformation Numérique Sécurité Informatique Intégration & Automatisation