Por qué debería alojar su propia IA #
Escribir textos, resumir correos electrónicos, crear imágenes: la IA generativa hace tiempo que forma parte del día a día laboral. Cada vez más empresas utilizan la inteligencia artificial de forma productiva, automatizan procesos y aprovechan nuevos potenciales de eficiencia. Con ello, las herramientas de IA pasan de ser un juego de experimentación a convertirse en una tecnología crítica para el negocio.
Por eso, en muchos sitios crecen tanto las dudas como las exigencias en cuanto a protección de datos, soberanía de los datos, control de costes y seguridad informática. Quien transmite datos sensibles de la empresa, documentos internos o código fuente a servicios externos de Cloud AI debería tener claro dónde acaban esos datos, en qué medida están protegidos o si se emplean para entrenar los modelos.
En cambio, si aloja una IA por su cuenta, traslada el tratamiento de los datos a su propia infraestructura . Un LLM local (Large Language Model) puede ejecutarse, por ejemplo, en un servidor de IA situado en el centro de datos de su empresa. Así crea la base técnica para la soberanía digital .
Alojar la IA por su cuenta: las principales ventajas de un vistazo #
- Máxima protección de datos: los datos sensibles permanecen dentro de su propia infraestructura de servidores y no se transmiten a servicios de IA externos.
- Soberanía digital: con un modelo de código abierto puede entrenar su propia IA y actuar con independencia de los grandes proveedores de IA.
- Control total de los costes: con una IA local no se generan costes por tokens en función del uso y se libra de las subidas de precio de la IA en la nube externa.
- Más flexibilidad: usted decide qué modelo de IA emplea, con qué datos lo entrena y cuándo instala nuevas versiones.
- Integración sin fisuras: a través de interfaces API, la IA local puede conectarse con bases de datos, aplicaciones y automatizaciones para formar un sistema completo.
Inteligencia artificial local frente a IA en la nube #
La decisión de utilizar IA en la nube o alojar la IA por su cuenta no es sencilla. Ambos enfoques tienen sus ventajas e inconvenientes. La preferencia por el self-hosting o por la Cloud AI depende sobre todo del peso que otorgue a determinados criterios. Valore, por tanto, cuán altas son realmente sus exigencias en materia de soberanía digital, protección de datos, cumplimiento normativo, escalabilidad, tamaño del modelo y costes totales.
-
Los Cloud AI Services destacan a menudo por un escalado sencillo y en función del uso y por una puesta en marcha rápida sin instalación de hardware. Es decir, no tiene que adquirir ni mantener infraestructura de GPU, sino que utiliza los servidores de IA del proveedor. Para tareas puntuales, fases de prueba o un uso muy fluctuante y difícil de prever, la IA en la nube puede resultar especialmente atractiva.
-
Frente a ello, la inteligencia artificial local en su propio servidor de IA ofrece el control total sobre el tratamiento de los datos. Usted decide qué modelos emplea, con qué sistemas están integrados y qué datos procesan. Con un uso de IA constantemente elevado y datos (confidenciales) de gran valor, el self-hosting también resulta interesante desde el punto de vista económico.
| Criterio | IA local | IA en la nube |
|---|---|---|
| Hardware | en propiedad | alquilado según necesidad |
| Control de los datos | muy alto | escaso, depende del proveedor |
| Escalabilidad | poco flexible, depende del hardware | muy flexible y sencilla |
| Esfuerzo de mantenimiento | alto | bajo |
| Costes | elevados costes de adquisición y explotación | costes de licencia corrientes, normalmente según el uso |
| Funcionamiento sin conexión | posible | no posible |
Hardware e infraestructura: ¿qué necesita un servidor de IA propio? #
Si desea alojar una IA por su cuenta, no debería fijarse únicamente en las capacidades de los modelos. Lo decisivo es la interacción entre hardware, tamaño del modelo y procesos de negocio concretos. Por eso la pregunta central es: ¿cuánta potencia de cálculo necesita para sus procesos de IA? Su propio servidor de IA necesita ante todo GPU, VRAM, almacenamiento SSD y refrigeración. Si hay varios usuarios en paralelo, se añaden además un aprovechamiento eficiente de la GPU y ancho de banda de red.
GPU y VRAM #
Las unidades de procesamiento gráfico (Graphics Processing Units, GPU) constituyen hoy en día el corazón de los servidores de IA. Para los LLM resulta especialmente relevante la VRAM (Video Random Access Memory) disponible de la GPU. Se entiende por ello la memoria local de una tarjeta gráfica, que sirve de memoria intermedia rápida para crear textos, gráficos e imágenes.
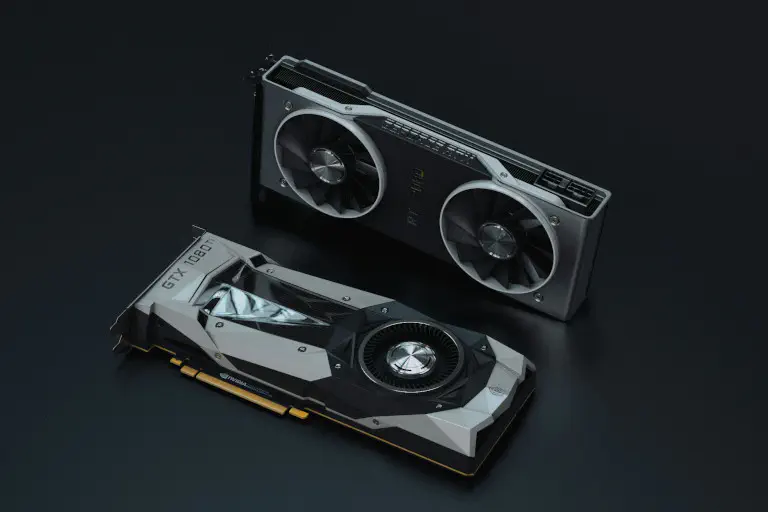
No siempre tiene que rascarse el bolsillo para adquirir tarjetas gráficas. Los modelos de IA pequeños pueden ejecutarse en parte en hardware de consumo potente con hasta 12 GB, mientras que los modelos más grandes requieren bastante más memoria de GPU (por lo general, más de 24 GB).
Infraestructura física #
Un servidor de IA propio puede liberar mucho calor residual y tener un consumo eléctrico y un rendimiento enormes. Para poder alojar la IA por su cuenta necesita, además de los componentes ya mencionados, sistemas de refrigeración, cableado, redes, suministro eléctrico ininterrumpido y, por supuesto, salas de servidores específicas donde ubicar su propio servidor de IA.
Modelos adecuados para alojar la IA por su cuenta #
¿Qué modelos de IA son los más adecuados para utilizar una IA de forma local? Eso depende principalmente del tamaño del modelo deseado, del caso de uso y del hardware disponible.
Tamaños de modelos de IA de 7B a 70B #
7B y 70B representan el número de parámetros de un modelo de IA en miles de millones (en inglés, «billion»), de modo que 7000 millones de parámetros corresponden a un modelo pequeño y 70 000 millones de parámetros a un modelo grande. Según el caso de uso, puede ser más adecuado un modelo 7B pequeño, rápido y económico o un modelo 70B grande, exigente en cálculo y costoso, si desea alojar la IA por su cuenta. El siguiente resumen sirve como orientación aproximada:
- Los modelos 7B son ideales para tareas sencillas como chats y automatizaciones simples. Pueden entender textos corrientes, escribir resúmenes o responder preguntas sencillas. Sin embargo, cometen errores con acertijos lógicos complicados o con conocimientos especializados profundos. A cambio, necesitan poca electricidad y potencia de cálculo y pueden funcionar ya en un PC gaming convencional.
- Los modelos 70B pueden resolver problemas complejos, asumir tareas empresariales más exigentes y debatir sobre temas difíciles como un experto. Pero tardan más en calcular y responder y tienen altos requisitos de VRAM. Por ello consumen bastante más electricidad en funcionamiento y necesitan costosas tarjetas gráficas profesionales, que normalmente se encuentran en centros de datos.
| Aspecto | Modelos 7B | Modelos 70B |
|---|---|---|
| Tamaño del modelo | pequeño | grande |
| Velocidad de respuesta | muy rápida | perceptiblemente más lenta |
| Lógica | sencilla | compleja |
| Requisitos de hardware | relativamente bajos | muy altos |
| Costes | económicos | elevados |
| Ámbitos de uso típicos | p. ej. automatización sencilla, chatbots | p. ej. análisis complejos y tareas exigentes |
Cuantización #
Además, no solo debería fijarse en el tamaño del modelo, sino también en la cuantización. Y es que las variantes cuantizadas de los modelos necesitan bastante menos VRAM que los modelos con precisión completa. Por cuantización se entiende la reducción de la precisión de cálculo en los modelos de IA, por ejemplo de números en coma flotante de 32 bits a números enteros de 8 bits. Con ello se acepta un compromiso entre la velocidad y la precisión de los cálculos.
La cuantización reduce el esfuerzo de cálculo y puede hacer que los modelos grandes resulten viables para sistemas de IA locales, ya que aumenta la velocidad de respuesta manteniendo la misma potencia de cálculo del hardware. Una estrategia sensata al alojar la IA por su cuenta es empezar primero con un modelo cuantizado. Así puede comprobar qué velocidad de respuesta y qué calidad exige su caso de uso concreto antes de invertir en una infraestructura de GPU más potente.
Modelos de código abierto con los que puede alojar la IA por su cuenta #
Si desea alojar la IA por su cuenta, resultan especialmente indicados los modelos de código abierto no comerciales con distintos tamaños y capacidades. Un modelo muy popular es Llama 3.3, que actualmente se considera el estándar para servidores de IA propios con hardware potente. Aquí puede ver una comparación de Llama 3.3, del grupo estadounidense Meta, con un modelo europeo de Mistral y una alternativa china de Alibaba. Todos los modelos son de código abierto y utilizan cuantización Q4, con lo que las necesidades de memoria se reducen aproximadamente a una cuarta parte en comparación con la precisión completa.
| Nombre | Proveedor | Tamaño | Ámbito de uso principal | VRAM necesaria |
|---|---|---|---|---|
| Llama 3.3 | Meta | 70B | todoterreno con lógica compleja | 42 a 45 GB |
| Qwen 2.5 Coder | Alibaba | 32B | programación y análisis de datos | 20 a 24 GB |
| Mistral Large 2 | Mistral | 123B | aplicaciones de negocio y agentes | 75 a 80 GB |
Instalar y utilizar la IA de forma local: Ollama, vLLM y compañía #
Si desea instalar una IA de forma local, hoy ya no tiene que desarrollar una arquitectura de software compleja. Algunas herramientas pueden facilitar considerablemente los primeros pasos.
Ollama #
Ollama es un software de código abierto que le permite utilizar la IA de forma local. Con la ayuda de Ollama puede descargar modelos de lenguaje de libre acceso directamente en su ordenador y ponerlos a disposición de multitud de aplicaciones a través de una interfaz estandarizada. Un inconveniente es que Ollama no dispone de interfaz gráfica de usuario para Linux, por lo que exige conocimientos técnicos previos.
vLLM #
Al igual que Ollama, vLLM es un motor de inferencia de código abierto para grandes modelos de lenguaje (LLM). Sin embargo, la configuración y los casos de uso son, en comparación, más exigentes. vLLM está diseñado para un alto rendimiento y varias GPU y resulta especialmente adecuado para servidores de IA propios con muchas solicitudes en paralelo. Se caracteriza por hacer que el funcionamiento de los modelos de IA en hardware propio sea más rápido, más eficiente y más escalable.
LM Studio #
Gracias a una aplicación de escritorio con interfaz gráfica fácil de manejar, LM Studio destaca como alternativa accesible a Ollama y vLLM. Además, LM Studio integra la plataforma Hugging Face, que permite acceder a distintos modelos de IA. En cuanto haya descargado e instalado un modelo adecuado, podrá interactuar de inmediato con el chatbot. A cambio, LM Studio también consume más recursos y no es de código abierto.
Open Web UI #
Otro componente interesante, en caso de que desee alojar la IA por su cuenta, es Open Web UI. Con esta plataforma de IA autoalojada puede crear una interfaz web fácil de usar para modelos de IA que ejecute localmente, por ejemplo, con Ollama o vLLM. Así, un LLM local inicialmente poco accesible se convierte en una aplicación que también pueden utilizar personas sin conocimientos técnicos especializados.
Ejemplo de arquitectura para alojar la IA por su cuenta #
Una arquitectura típica podría tener este aspecto:
Usuario → Open Web UI → Ollama o vLLM → LLM local
De este modo puede instalar una IA de forma local y conectar aplicaciones mediante API. Si utiliza la IA localmente, debería tener en cuenta desde el principio también la monitorización, la autenticación, los permisos, las copias de seguridad y las actualizaciones. Poner en marcha un LLM en su propio servidor de IA es, técnicamente, solo el primer paso hacia un sistema productivo y seguro.
No-Code AI y flujos de trabajo: integrar la IA de forma inteligente #
El mayor valor añadido no suele surgir de la IA en sí, sino de su integración en los procesos de negocio . Una inteligencia artificial local puede, por ejemplo, analizar nuevos registros de una base de datos interna, clasificar textos o resumir documentos entrantes. A través de una interfaz API, el resultado puede transferirse después, por ejemplo, a un sistema CRM o iniciar una automatización.
Gracias a la No-Code AI —por ejemplo, con un No Code AI Workflow Builder— puede modelar estos procesos en gran medida sin programación clásica. Esto reduce el esfuerzo de desarrollo y hace que las funciones de IA sean accesibles para los citizen developers de la empresa. Si aloja por su cuenta tanto el No Code AI Workflow Builder como la propia IA, el tratamiento de los datos tiene lugar exclusivamente dentro de su propia infraestructura.
Las automatizaciones de IA de SeaTable #
En SeaTable usted elige: aproveche la escalabilidad y la comodidad de la nube o instale SeaTable on-premises en su propia infraestructura. Como plataforma No-Code con IA , SeaTable le abre posibilidades interesantes, como la combinación de No Code , bases de datos relacionales y automatizaciones de IA : utilice funciones potentes como Summarize, OCR, Extract, Classify y Custom Prompts.
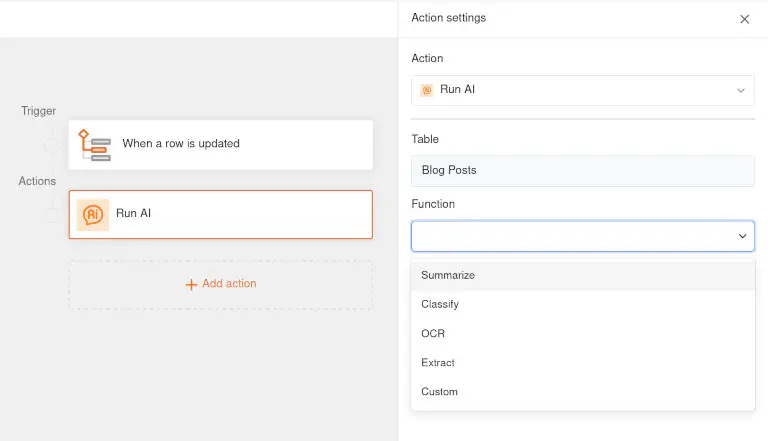
SeaTable Cloud emplea como modelo de IA un Gemma3 de Google con 12 000 millones de parámetros. Para los usuarios de la nube, las automatizaciones de IA se ejecutan en nuestro propio servidor de IA en Alemania. Sus datos no abandonan esta infraestructura en ningún momento y no llegan a Google ni a otros proveedores estadounidenses.
Para un control total puede alojar por su cuenta no solo SeaTable Server , sino también su IA. Así puede automatizar flujos de trabajo sin tener que transmitir información sensible a una IA en la nube externa. El componente SeaTable AI se basa en LiteLLM y admite, por tanto, la conexión de multitud de modelos, entre ellos todos los servicios LLM con una API compatible con OpenAI. En nuestro manual de administración encontrará las instrucciones para el despliegue de SeaTable AI y configuraciones de ejemplo para numerosos LLM populares.
Conectar agentes de IA con SeaTable #
¿Le gustaría mantener un diálogo en tiempo real sobre su base de datos en SeaTable o editarla con prompts individuales en lenguaje natural? Entonces un agente de IA es justo la solución adecuada. Detrás de este enfoque está el servidor MCP de SeaTable . MCP (Model Context Protocol) es un estándar abierto que permite a los modelos de IA interactuar activamente con fuentes de datos. Así, el chatbot puede acceder directamente a su base de datos en SeaTable y responder preguntas sobre ella, sin rodeos ni pérdida de información.
Esto funciona mejor con modelos de IA potentes (p. ej. Claude Desktop de Anthropic), capaces de responder preguntas complejas y de trabajar con sus datos en varios pasos. Por motivos de protección de datos es importante entender que usted concede al agente de IA acceso a los datos de su base de SeaTable. Los permisos del agente de IA se controlan mediante el token de API que genera en SeaTable. Si aloja una IA por su cuenta, puede instalar tanto SeaTable como el servidor MCP en su propia infraestructura y conectarlos con la IA local (por ejemplo, mediante Ollama o LM Studio). De este modo, sus datos no abandonan su sistema en ningún momento. Encontrará más información al respecto aquí .
Conclusión: alojar la IA por su cuenta proporciona independencia digital #
Si aloja su propia IA, decide usted mismo sobre el modelo de IA, opera su propio servidor de IA y conserva el control total sobre sus datos. Esto resulta especialmente interesante para las empresas con altos requisitos de protección de datos y para el sector público . Ahora bien, quien desee alojar la IA por su cuenta debería planificar la infraestructura de forma realista: la GPU y la VRAM determinan en gran medida el tamaño de modelo posible, mientras que la cuantización puede optimizar la velocidad.
Con la arquitectura adecuada y software de código abierto como Ollama o vLLM, la IA puede utilizarse de forma local e integrarse mediante API en los procesos empresariales existentes. Las herramientas de No-Code AI como SeaTable le permiten, por su parte, automatizar sus flujos de trabajo de forma eficiente, así como analizar y editar sus bases de datos No-Code con agentes de IA, sin tener que transmitir datos empresariales sensibles a una IA en la nube externa.
FAQ: alojar la IA por su cuenta #
¿Cuál es la mayor ventaja de alojar una IA propia?
¿Qué hardware necesito para un servidor de IA propio?
¿En qué se diferencia el rendimiento de la IA local y el de la IA en la nube comercial?
¿Puedo conectar una IA local con herramientas No-Code y automatizaciones?
¿Qué modelos de código abierto son adecuados para utilizar una IA de forma local?
TAGS: Transformación Digital Seguridad Informática Y Privacidad De Datos Integraciones Y Automatizaciones